
주문 하나가 여러 서비스를 거치는 동안 어느 한 곳이 실패하면, 이미 끝난 앞 단계들은 어떻게 되나. 이 질문에 답하려면 먼저 누가 그 순서를 쥐고 있는지부터 정해야 한다. 흐름을 지휘하는 두 방식을 가른 다음, 정합성을 맞추는 네 가지 전략을 비교하고, 마지막에는 그중 하나를 Temporal로 직접 굴려 본 결과까지 이어 간다.
1. 먼저, 이 흐름을 누가 지휘하나
여러 마이크로서비스가 하나의 업무(예: 주문 → 결제 → 재고 → 알림)를 함께 처리할 때, “이 흐름을 누가, 어떻게 이어 붙이느냐”는 두 갈래로 나뉜다. 오케스트레이션(orchestration)과 코레오그래피(choreography)다. 분산 트랜잭션을 이야기하려면 이 둘부터 갈라 놓아야 해서, 먼저 정리한다.
1-1. 한 장으로 보는 차이
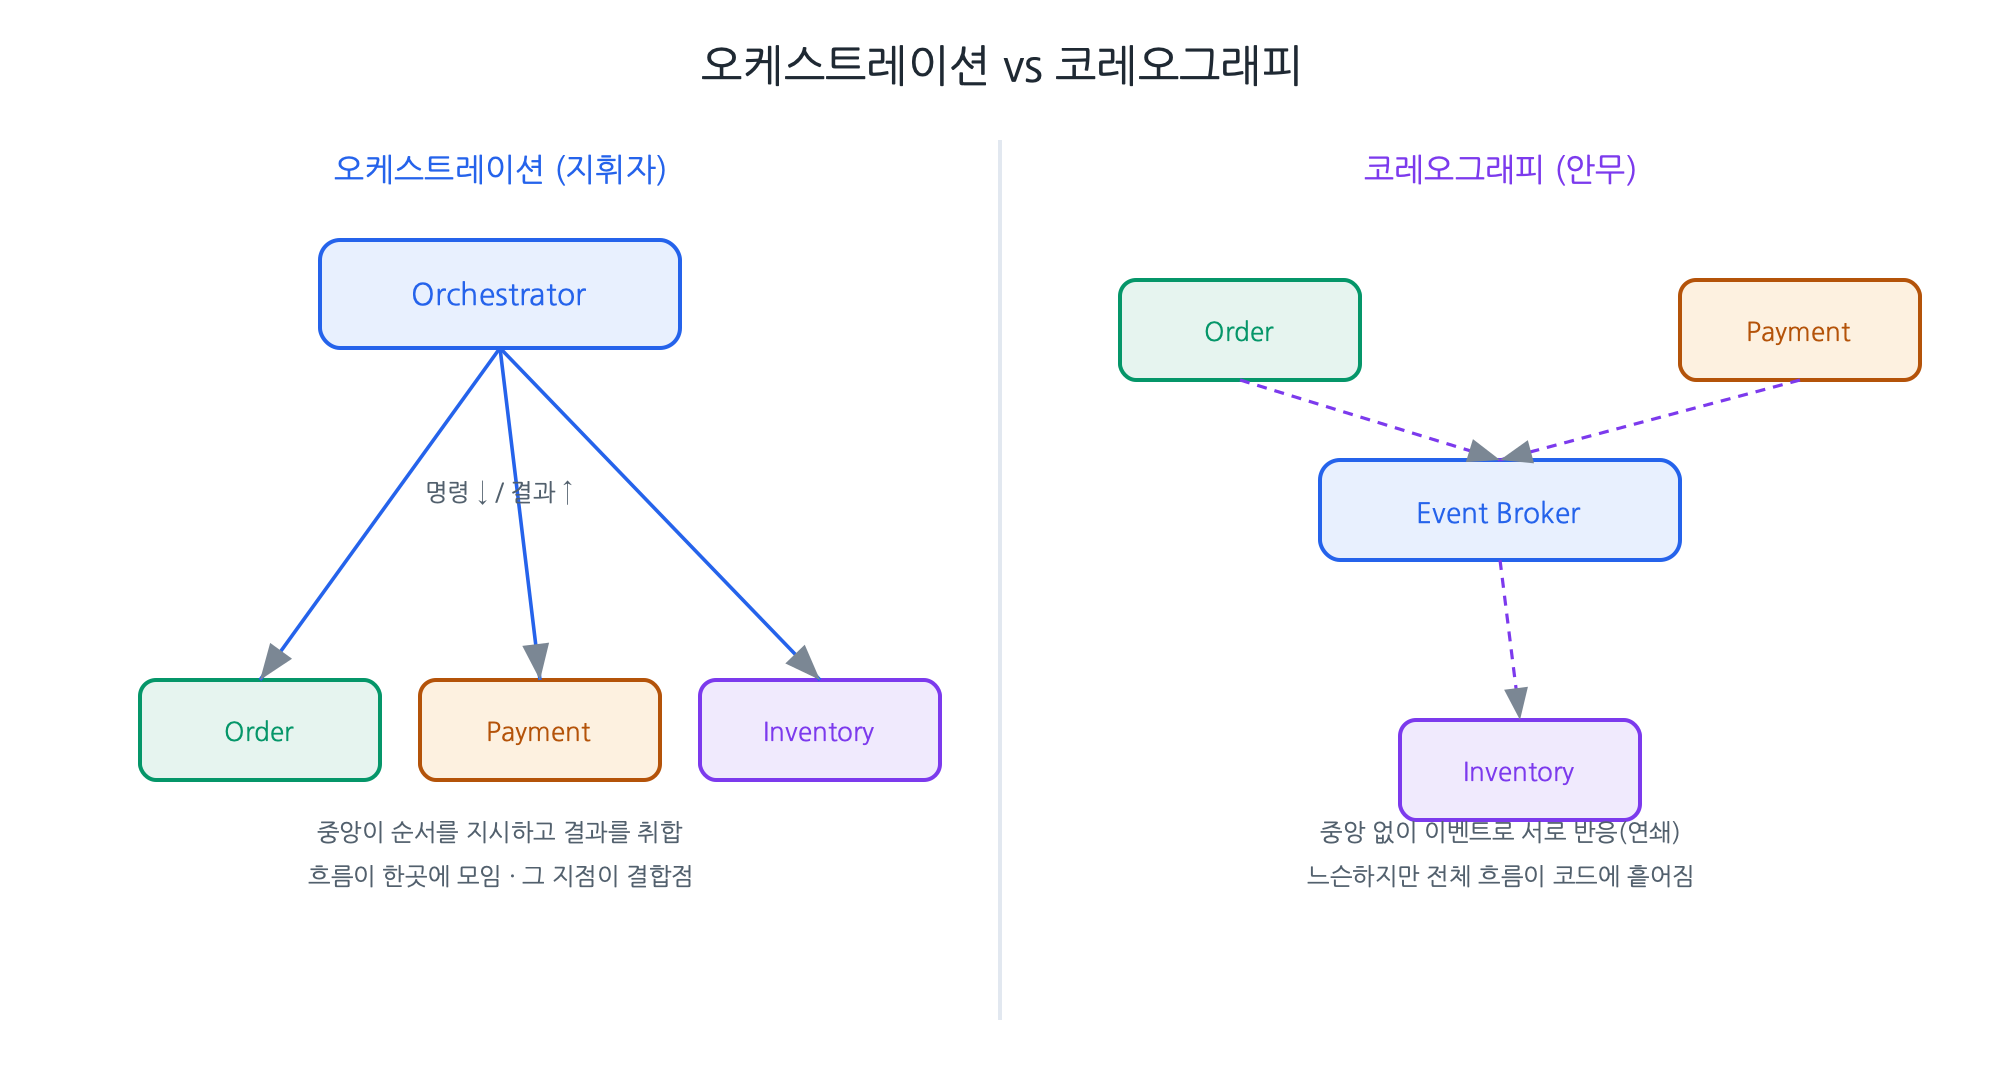
1-2. 코레오그래피(안무) — 중앙 없이 이벤트로 연쇄
지휘자가 없다. 각 서비스는 다른 서비스가 낸 이벤트를 듣고 자기 일을 한 뒤, 다음 이벤트를 낸다. Order가 OrderCreated를 내면 Payment가 그걸 듣고 결제한 뒤 PaymentSettled를 내고, Inventory가 다시 그걸 듣는 식이다. (EDA 편에서 본 pub/sub 구조 그대로.)
- 장점 — 서비스 간 결합이 느슨하다. 소비자를 새로 붙여도 기존 서비스는 그대로다.
- 단점 — 전체 흐름이 어디에도 한눈에 안 보인다. 로직이 여러 서비스에 흩어져, “지금 이 주문이 어디까지 갔지?”를 추적하기 어렵고 순환 의존이 생기기도 한다.
1-3. 오케스트레이션(지휘자) — 중앙이 순서를 지시
오케스트레이터(orchestrator)라는 중앙 조율자가 흐름을 지휘한다. “Payment 호출 → 성공하면 Inventory 호출 → 실패하면 이렇게” 같은 순서와 분기를 한곳에서 관리하고, 각 서비스를 명령으로 부르고 결과를 취합한다.
- 장점 — 전체 흐름이 한곳에 모여 보이고, 바꾸기·모니터링하기 쉽다. 실패 처리·재시도·타임아웃을 중앙에서 일관되게 건다.
- 단점 — 오케스트레이터가 결합점이 된다. 이 지점의 설계·가용성이 전체를 좌우한다.
1-4. 언제 무엇을
| 코레오그래피 | 오케스트레이션 | |
|---|---|---|
| 흐름의 소재 | 여러 서비스에 분산 | 오케스트레이터 한곳 |
| 결합도 | 느슨함 | 중앙에 집중 |
| 가시성/추적 | 어렵다 | 쉽다 |
| 적합 | 단순·독립적인 파급 | 순서·분기·보상이 복잡한 업무 |
둘은 배타적이지 않다. 큰 시스템은 대개 섞어 쓴다 — 느슨한 파급은 이벤트로, 순서가 중요한 핵심 업무는 오케스트레이터로. 그리고 그 “순서가 중요한 핵심 업무”에서 곧바로 부딪히는 것이 분산 트랜잭션이다.
2. 네 가지 접근, 그리고 아웃박스
모놀리스라면 트랜잭션 하나로 BEGIN … COMMIT 하면 그만이다. 그런데 MSA에서는 서비스마다 DB가 따로라, 여러 서비스에 걸친 하나의 원자적 트랜잭션을 그렇게 묶을 수 없다. (MSA 편의 “DB per Service”가 이 문제의 뿌리다.) 이걸 다루는 방식은 크게 넷이다. 그리고 이 넷이 공통으로 기대는 전달 계층으로 아웃박스 패턴을 하나 더 곁들여 본다.
| 방식 | 핵심 | 실패 처리 | 대가 |
|---|---|---|---|
| 2PC (2단계 커밋) | 코디네이터가 prepare→commit 로 원자적 커밋 | 전원 준비돼야 커밋 | 블로킹·잠금 유지, 코디네이터 장애 시 전체 정지, 가용성↓ |
| 3PC (3단계 커밋) | pre-commit 단계를 더해 블로킹 완화 | 일부 장애에 비블로킹 | 메시지 왕복↑, 네트워크 지연·분단 가정이 비현실적 — 실무 채택 드묾 |
| Saga | 로컬 트랜잭션 체인 + 실패 시 보상(compensating) 트랜잭션으로 되돌림 | 뒤로 되돌리기(undo) | 보상 로직을 완벽히 짜기 어렵고, 이미 나간 부수효과(메일 등)는 깔끔히 안 돌아감 |
| Durable Execution (이벤트 체이닝) | 흐름을 지속 실행 워크플로로 두고 자동 재시도, 실패 지점에서 멈춤 | 앞으로 고쳐 재개(fix-forward) | 워크플로 엔진(오케스트레이터) 도입 필요 |
| 아웃박스 패턴 (Transactional Outbox) | DB 변경과 ‘보낼 이벤트’를 같은 로컬 트랜잭션으로 outbox 테이블에 함께 커밋 → 릴레이가 브로커로 전달 | 전달 실패 시 재발행(at-least-once) | 정확히-한-번이 아닌 최소-한-번 — 소비자 멱등 필수, 릴레이·폴링 인프라 |
아웃박스는 앞의 넷과 결이 조금 다르다. 2PC·3PC·Saga·durable execution이 “여러 서비스에 걸친 결과를 어떻게 맞출까”를 다룬다면, 아웃박스는 그보다 한 층 아래 — “내 DB를 바꾸면서 그 사실을 브로커로 어떻게 확실히 흘려보낼까”를 푼다. 흔한 함정이 이중 쓰기(dual write)다. DB에 커밋한 뒤 이벤트를 따로 발행하면, 그 사이에 프로세스가 내려가는 순간 DB엔 반영됐는데 이벤트는 안 나간 어긋남이 생긴다. 아웃박스는 이벤트를 DB 트랜잭션 안에 함께 적어 두고 뒤에서 릴레이가 읽어 보내는 식으로 그 틈을 메운다. 그래서 아웃박스는 독립적인 ‘정합성 전략’이라기보다, Saga·EDA·durable execution이 흘려보내는 이벤트가 유실되지 않게 받쳐 주는 토대에 가깝다. 이 글 뒤쪽(6-3의 ③, 6-4)에서 부수효과와 Confirm 전파를 이야기할 때 아웃박스가 계속 등장하는 이유이기도 하다.
3. 솔직히, 앞의 셋은 잘 납득이 안 갔다
세 방식 모두 널리 쓰이는 정당한 패턴이다. 다만 내 직관으로는 이런 지점이 계속 걸렸다.
- 2PC / 3PC — 원자적 커밋을 얻으려고 서비스들을 강하게 묶고 가용성을 희생한다. 잠금을 오래 쥐고, 코디네이터에 흐름이 종속된다. 서비스를 독립적으로 쪼갠 MSA의 취지와 정면으로 부딪힌다. 3PC는 이를 완화하지만, 그게 성립하려면 네트워크가 착하게 굴어야 한다는 가정이 현실과 멀다.
- Saga — “실패하면 되돌리자(보상)“가 핵심인데, 현실에서 깨끗한 undo는 생각보다 드물다. 결제 취소는 그렇다 쳐도, 이미 발송한 알림·정산에 반영된 수치·외부로 나간 부수효과는 원상복구가 어렵다. 보상 트랜잭션을 모든 경우에 정확히 작성하는 것 자체가 큰 부담이다.
4. 가장 납득된 건 — 멈추고, 고치고, 그 지점부터 재개
내게 가장 자연스러웠던 건 마지막이다. 트랜잭션이 중요한 핵심 로직에서 실패가 나면, 되돌리지 말고 그 지점에서 멈춘다. 이미 성공한 앞 단계는 그대로 두고(재실행하지 않고), 실패한 부분의 원인을 직접 확인해 고친 뒤, 바로 그 지점부터 앞으로 다시 이어서 실행한다. 되돌리기(undo)가 아니라 고쳐서 전진(fix-forward)이다.
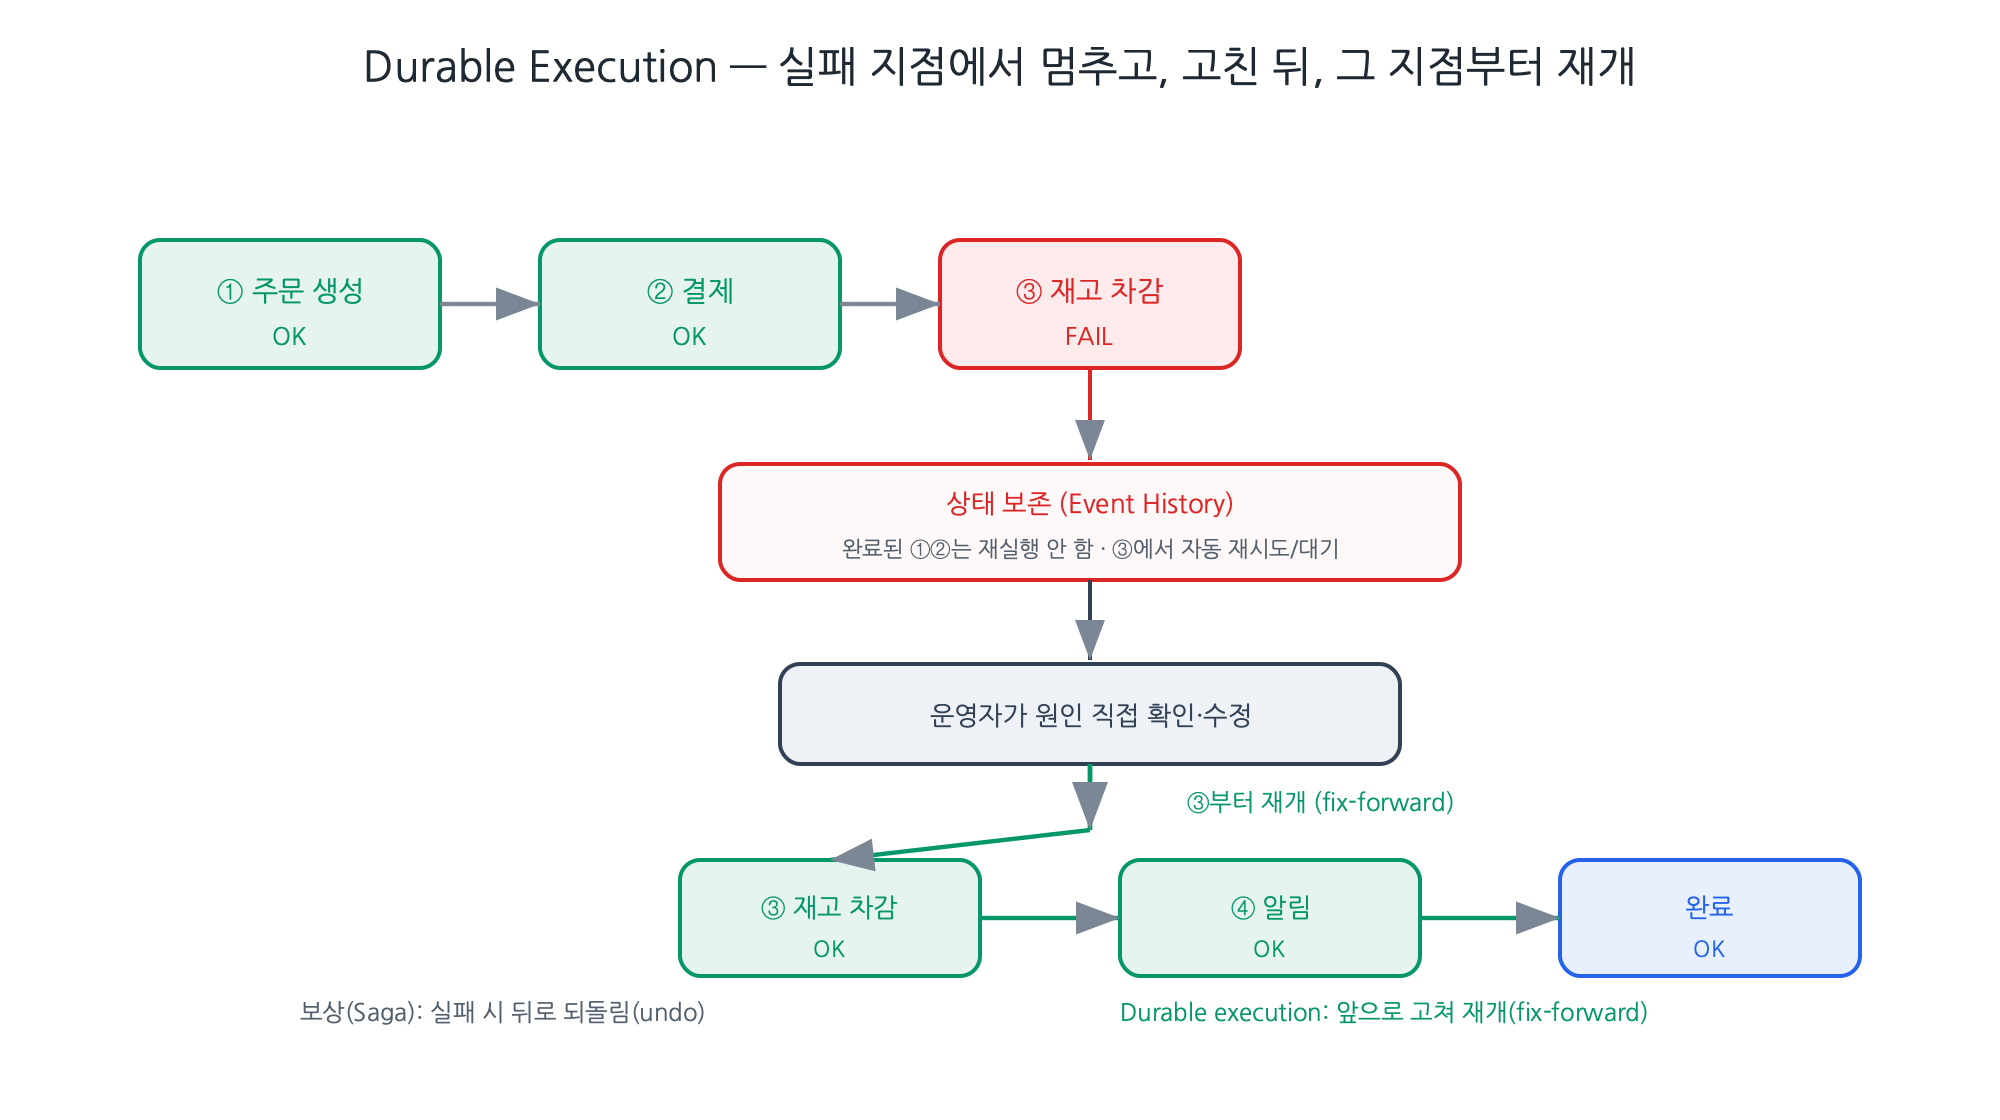
이 방식이 좋은 이유는, 이미 반영된 것을 억지로 되돌리지 않아도 된다는 점이다. 대부분의 실패는 일시적(다운스트림 서비스 순단, 잘못된 설정, 데이터 이슈)이라, 원인만 제거하면 되돌릴 필요 없이 그대로 앞으로 가면 된다.
5. 직접 굴려 보려다, 이미 만들어 둔 사람들을 만났다 — Temporal
사실 이 ‘멈추고 고쳐 재개’를 처음엔 직접 굴려 보려고 했다. 마침 앞서 정리한 아웃박스가 손에 잡혔다 — 워크플로의 진행 상태와 다음에 할 일을 outbox 테이블에 상태로 남기고, 릴레이가 그 로그를 읽어 다음 단계를 밀고, 실패하면 그 지점의 레코드를 붙잡아 두었다가 원인을 고친 뒤 다시 태우는 식이다. 상태를 DB에 지속시키니 워커가 도중에 내려가도 이력을 읽어 이어 갈 수 있겠다 싶었다.
그렇게 한참 삽질을 하다 문득 멈칫했다. 상태 지속, 이력 재생, 멱등 재시도, 실패 지점 보존 — 제대로 갖추려니 챙길 게 끝없이 딸려 나왔다. 그때 든 생각이 이거였다. “이렇게 자연스러운 발상을, 설마 나만 하고 있을까.” 비슷한 고민을 먼저 한 사람이 분명 있을 것 같아 찾아봤고 — 예상대로, 이미 이걸 프레임워크로 만들어 둔 사람들이 있었다. 그게 Temporal이었다.
내가 그동안 이름을 헷갈려 부르던(“Tempo”) 바로 그것, Temporal(temporal.io)이 이 지속 실행(durable execution)을 정확히 제공한다. 동작을 요약하면:
- 워크플로를 코드로 — “해피 패스”를 평범한 코드로 쓰면, 실패·재시도·상태 보존은 엔진이 알아서 처리한다.
- Event History (이벤트 소싱) — 워크플로의 각 단계 상태를 이벤트로 기록한다. 그래서 워커가 죽어도 이력을 재생(replay)해 실패 지점까지 상태를 복원하고 이어서 실행한다.
- 완료 단계는 재실행 안 함 — 이미 성공한 액티비티의 결과는 재사용한다. 위 그림의 ①②를 다시 돌리지 않는 이유다.
- 자동 재시도 — 액티비티 실패 시 지수 백오프로 재시도한다. 다운스트림이 복구되면 실패가 없었던 것처럼 이어진다. (원인이 사람 손을 타야 하면, 그 지점에서 대기시켜 두고 고친 뒤 재개할 수 있다.)
엄밀히 말하면 Temporal로 Saga를 구현하기도 한다. 다만 내가 이 글에서 대비하는 건, “실패 시 보상으로 되돌리는” 고전적 Saga와 “실패 지점에서 멈춰 고쳐 앞으로 재개하는” durable execution이라는 두 태도다. 나는 후자가 핵심 트랜잭션에서 훨씬 납득이 간다.
6. 한 걸음 더 — 이미 성공한 1·2는 어떻게 되나
여기서 자연스러운 질문이 하나 생긴다. 오케스트레이터가 5개 서비스를 부르다 3번째에서 실패했다면, 이미 성공한 1·2는 어떻게 되나? 1·2는 각자 API 호출에 성공해 자기 DB에 커밋까지 했을 텐데, 대체 무엇을 “재개”한다는 걸까?
6-1. ‘성공’은 무엇으로 판정하나
핵심은, 재개가 1·2를 다시 부르거나 되돌리는 게 아니라는 점이다. 오케스트레이터는 자기 이벤트 히스토리(durable state)에 “액티비티1 완료(결과 X), 액티비티2 완료(결과 Y)”를 기록해 둔다. 그래서 3에서 멈췄다가 재개할 때, 오케스트레이터는 1·2에게 다시 묻지 않고 자기 로그를 읽어 이어 간다. “1·2의 성공”은 서비스에 재확인하는 게 아니라 워크플로 이력이 판정하는 것이다.
여기에 안전장치가 하나 더 붙는다. 멱등키(idempotency key, 보통 워크플로 ID)다. 오케스트레이터가 실패로 오해해 같은 요청을 다시 보내도, 서비스는 같은 키의 요청을 한 번만 반영한다. 덕분에 재시도가 이중 결제·이중 차감을 만들지 않는다.
6-2. ‘재개’는 3만 다시 한다 — 두 종류의 실패
그래서 재개의 대상은 실패한 3번뿐이고, 1·2는 커밋된 채 그대로 둔다. 다만 반드시 갈라야 할 것이 있다. 실패에는 두 종류가 있다.
| 실패 종류 | 예 | 처리 |
|---|---|---|
| 일시적(transient) | 3번 순단·타임아웃·일시 오류 | 3만 재시도 → 자동 수렴 (이 글의 fix-forward) |
| 업무적(business) | 3번이 “재고 없음”으로 영구 거절 | 재시도해도 실패 → 이때 비로소 1·2를 어떻게 할지 결정 필요 |
일시적 실패라면 fix-forward로 충분하다. 문제는 업무적·영구 실패다. 3이 앞으로도 계속 거절한다면, 이미 반영된 1·2를 되돌리거나, 애초에 확정을 미뤄 두는 장치가 필요하다.
6-3. 1·2를 되돌리지 않으려면 — 세 가지 결
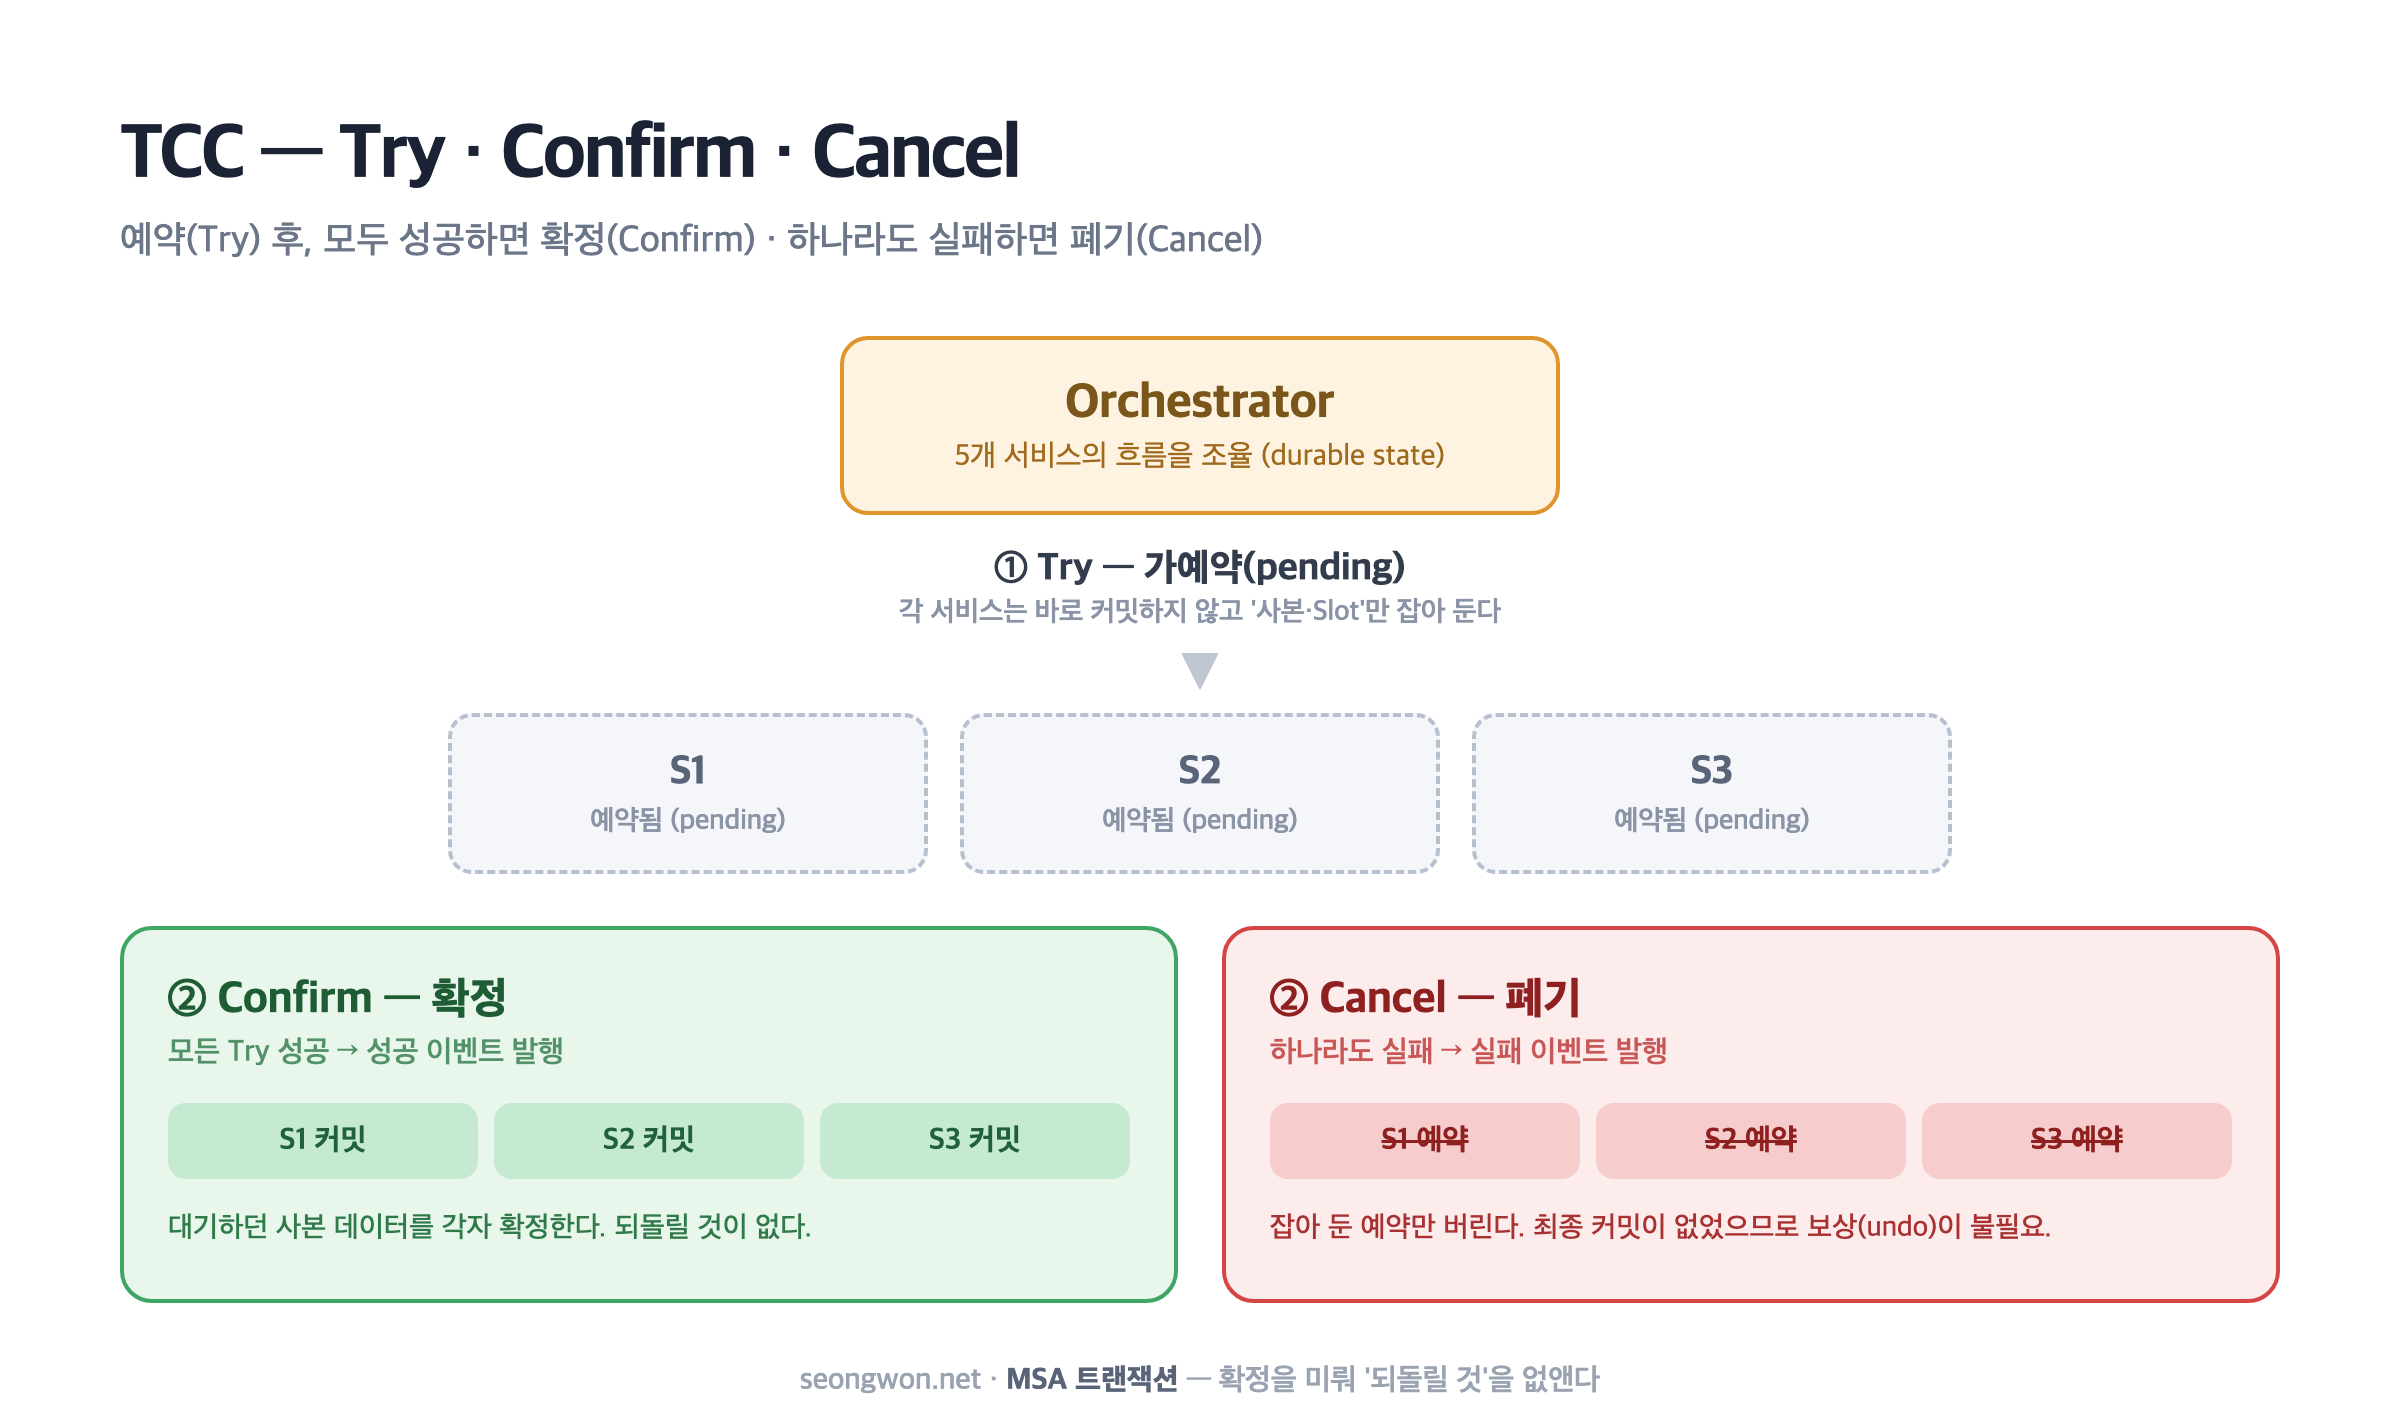
이 지점을 푸는 방법은 크게 셋이다.
① 예약 후 확정 — TCC(Try-Confirm-Cancel). 각 서비스가 요청을 받으면 바로 커밋하지 않고 ‘가예약(pending slot)’만 만든다(Try). 오케스트레이터가 전 단계 성공을 확인하면 각 서비스에 확정 신호를 보내고(그 전달 방식은 6-4에서 두 가지로 다룬다), 그때 각 서비스가 대기 중이던 데이터를 확정(Confirm)한다. 하나라도 실패하면 예약을 폐기(Cancel)한다. 아무것도 최종 커밋하지 않았으므로 “1·2가 이미 완료” 문제 자체가 사라지고, 되돌릴 것이 없다(폐기만). 대신 되돌리기 어려운 자원(재고·묶인 돈·좌석)을 쥔 서비스에만 try/confirm/cancel 3-way를 씌우면 된다 — 원자성이 중요한 지점에 선택적으로 적용하는 게 현실적이지, 모든 서비스가 3-way를 구현할 일은 아니다. 읽기 전용이거나 보상이 쉬운 서비스는 평범한 호출로 둔다. 예약을 쥔 서비스는 그 자원에 대한 의미적 잠금을 확정 전까지 쥐므로, 고아 예약을 정리할 타임아웃과 이벤트 유실을 막을 아웃박스 패턴이 필요하다. (확정 신호 후의 반영은 각 서비스가 멱등하게 재시도하는 형태라, 엄밀히는 ‘동시’가 아니라 ‘곧 모두 확정’이다.)
② 사전 검증 — dry-run / pre-flight. 실행 전에 각 서비스의 테스트 API로 “이 요청이 성공할까”를 미리 조사하고, 전부 참일 때만 실제 실행한다. 실패를 앞당겨 걸러 사가 도중 실패율을 낮춘다. 다만 읽기 전용 확인은 TOCTOU에 취약하다 — 확인과 실행 사이에 다른 요청이 재고를 채가면 무너진다. 진짜 안전하려면 ‘확인’이 아니라 ‘예약(잡기)’이어야 하고, 그러면 ①과 같아진다. 그래서 이건 보조 최적화이지 단독 정합성 근거는 아니다.
③ 이상적 조합 — 최종 일관성을 받아들이기. 현실의 답은 하나가 아니라 조합이다. Durable orchestration(상태 지속 + 실패지점 재시도) + 멱등성을 뼈대로 깔고, 되돌림이 어려운 도메인이면 ①TCC 예약을, 되돌림이 명확한 도메인이면 Saga 보상을 얹는다. 부수효과(메일·정산)는 아웃박스 + 멱등 소비자로 정확히 한 번 처리한다. 이 전체는 순간적인 부분 상태(1·2 완료 / 3 미완)를 허용하되 재시도·확정으로 수렴하는 최종 일관성(eventual consistency)을 전제한다.
| 방법 | 성격 | 강점 | 한계 |
|---|---|---|---|
| ① TCC 예약 | 확정을 미룸 | 되돌릴 게 없음, all-or-nothing 근접 | 예약 자원 한정 3-way·의미적 잠금·타임아웃 |
| ② 사전 검증 | 미리 걸러냄 | 실패를 앞당겨 차단 | TOCTOU, 단독으론 불충분 |
| ③ 조합(+보상) | 뒤에서 수습 | 범용, 부수효과까지 | 보상 로직 부담, 최종 일관성 수용 |
그래서 무엇이 가장 이상적인가. 분산 환경엔 공짜 ACID가 없어 단일 정답은 없다 — 실패 성격과 도메인이 답을 가른다. 내 결론을 굳이 하나 고르면, 되돌림이 부자연스러운 핵심 트랜잭션에서는 ①TCC 예약이 가장 깔끔하다. TCC는 되돌릴 커밋을 애초에 만들지 않아, 이 글이 앞세운 ‘보상 undo를 피한다’는 문제의식과 뿌리가 같다 — 다만 fix-forward가 ‘고쳐 전진’이라면 TCC의 실패 처리는 ‘예약 폐기(중단)’라는 점은 구분된다. 둘은 대체재가 아니라 durable orchestration 위에 함께 얹는 층이다. 다만 이건 취향이 아니라 맥락의 문제다 — 도메인이 단순하고 보상이 명확하면 Saga가 더 가볍고, 실패를 미리 줄이고 싶으면 ②사전 검증을 보조로 얹으면 된다. 어느 쪽이든 뼈대는 durable orchestration + 멱등성이고, 그 위에서 도메인에 맞는 결을 고르는 것이 핵심이다.
6-4. 그래서 실제로 어떻게 구현하나 — Temporal로 TCC 굴리기
개념을 코드의 자리로 내려 보면 이렇게 된다. 오케스트레이터 = Temporal Workflow이고, 각 서비스 호출은 Activity로 감싼다. 워크플로의 진행 상태(어느 서비스까지 예약됐는지)는 Temporal이 이벤트 히스토리로 durable하게 보존하므로, 워커가 죽어도 그 지점부터 재개된다. (직접 History 저장소를 만들 필요가 없다 — Temporal이 그 역할을 한다.)
흐름은 TCC 3단계를 워크플로 한 함수에 담는다.
// Orchestrator = Temporal Workflow (해피 패스를 코드로)
func PlaceOrderWorkflow(ctx, order):
    reserved = []
    // ── ① Try: 각 서비스에 '예약(hold)'을 건다 (결과 반영은 아직)
    for svc in [inventory, payment, shipping, ...]:
        ok = activity.Reserve(ctx, svc, order, workflowID)  // 멱등키=workflowID
        if not ok:
            break
        reserved.append(svc)

    if len(reserved) < N:
        // ── ③ Cancel: 하나라도 실패 → 잡아둔 예약만 폐기 (되돌릴 커밋이 없음)
        for svc in reserved:
            activity.Cancel(ctx, svc, order, workflowID)
        return FAILED

    // ── ② Confirm: 모두 예약 성공 → 예약 데이터를 최종 반영
    for svc in reserved:
        activity.Confirm(ctx, svc, order, workflowID)
    return DONE
각 서비스는 이 세 가지 엔드포인트를 갖는다.
Reserve(Try) — 값을 검증하고 자원을 잡아 pending으로 저장한다. 결과에는 아직 반영하지 않는다. (예: 재고를 ‘차감’이 아니라 ‘예약’으로 걸어 둠) 여기서 ‘확인만’ 하고 자원을 잡지 않으면 6-3 ②의 TOCTOU에 걸리므로, Try는 반드시 예약(hold)이어야 한다.Confirm— pending을 확정해 결과에 반영한다. (예: 예약된 재고를 실제 차감 확정)Cancel— pending을 폐기한다. 확정된 게 없으니 되돌릴 것도 없다.
세 활동 모두 workflowID를 멱등키로 받아, Temporal이 재시도로 같은 호출을 두 번 보내도 한 번만 반영되게 한다. Reserve가 일시적으로 실패하면 Temporal이 그 활동만 재시도하고(fix-forward), 업무적으로 거절되면 워크플로가 Cancel 경로로 빠진다. 워크플로의 위치는 히스토리에 남아 있으므로, 어느 단계에서 죽든 정확히 그 지점부터 이어진다.
Confirm을 알리는 두 방식 — 질문의 두 방향이 모두 여기 해당한다.
| 방식 | 어떻게 | 특징 |
|---|---|---|
| 동기 — 승인 API 재호출 | 워크플로가 Confirm 활동으로 각 서비스 승인 API를 직접 호출 |
Temporal이 재시도까지 보장. Temporal과 가장 잘 맞음 |
| 비동기 — 성공 이벤트 발행 | 워크플로가 “confirmed” 이벤트를 뿌리고 서비스가 구독해 확정 | 더 느슨하나 아웃박스 + 구독자 멱등 필요 |
정리하면 “Event로 반영”과 “승인 API 재호출”은 둘 다 유효한 Confirm 구현이다. 다만 오케스트레이터를 Temporal로 두면, 승인 API를 활동으로 호출하는 동기 방식이 재시도·상태보존을 그대로 얹을 수 있어 가장 단순하다.
7. 우선 MVP로 손에 익히기 — 그리고 다음 실험
개념이 납득됐으니, 먼저 작은 데모를 만들어 Temporal에 직접 올려 봤다. 흐름은 주문 → 예약(reserve) → 결제(charge) → 배송(ship)이고, 재고를 일부러 모자라게 둔 채 굴리며 데모의 상태 화면과 Temporal Web UI를 나란히 지켜봤다.
재고(3)보다 많은 수량(5)을 주문하면 reserve가 StockShortage로 실패한다. 그런데 이 오류는 retryable이라 워크플로우가 죽지 않고 재시도 루프에서 멈춘다 — 상태는 여전히 RUNNING이고, ‘고칠 수 있는 남은 시간’이 흐른다. 실패가 ‘끝’이 아니라 ‘막힘’으로 드러나는 것 — 이게 앞서 말한 ‘멈추고 고쳐 재개’가 화면으로 나타난 모습이다.
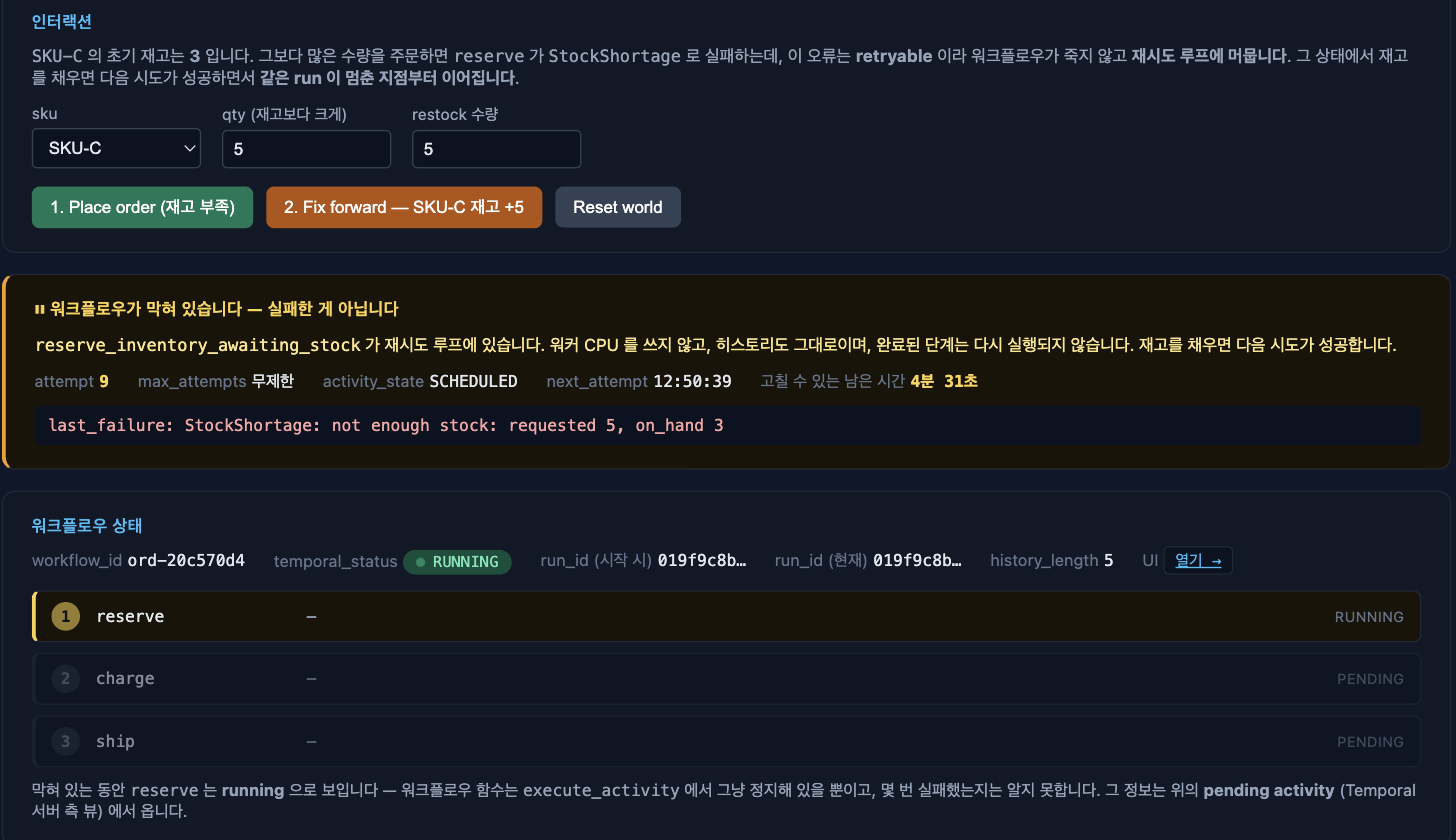
reserve가 StockShortage로 실패 — 하지만 워크플로우는 죽지 않고 RUNNING인 채 재시도 루프에서 멈춘다(attempt 9, 무제한). 실패가 아니라 ‘막힘’이다.여기서 재고를 채우면(데이터만 수정) 막혀 있던 다음 재시도가 성공하고, 같은 run이 멈춘 지점부터 이어져 COMPLETED가 된다. run_id는 처음 그대로고, 이미 성공한 charge·ship은 재실행되지 않는다. 고친 건 워크플로우 코드나 상태가 아니라 데이터 하나였다 — 되돌리기(undo) 없이 고쳐서 전진(fix-forward)이 실제로 굴러가는 걸 눈으로 확인한 셈이다.
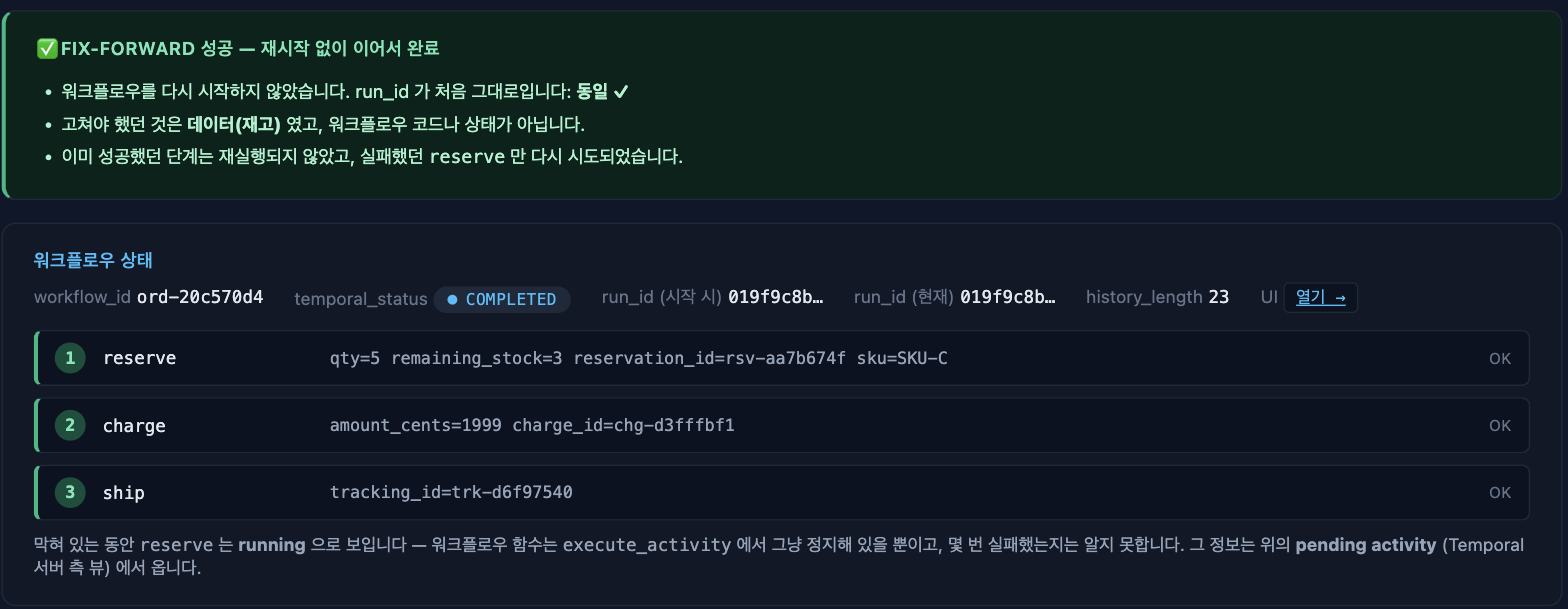
run_id 동일, 완료된 charge·ship은 재실행되지 않는다.Temporal Web UI의 타임라인을 보면 더 분명하다. reserve가 ↺7번 재시도로 21초를 끌다가, 재고가 채워지자 charge·ship이 거의 즉시 이어졌다. 흥미로운 건 그 21초의 실패 재시도가 이벤트 히스토리를 늘리지 않는다는 점이다 — 히스토리엔 성공 경로만 남고, 재시도 상태는 pending activity에 들어 있다. 재시도가 저렴하니 ‘막혀 있어도 괜찮은’ 설계를 마음 놓고 쓸 수 있다.
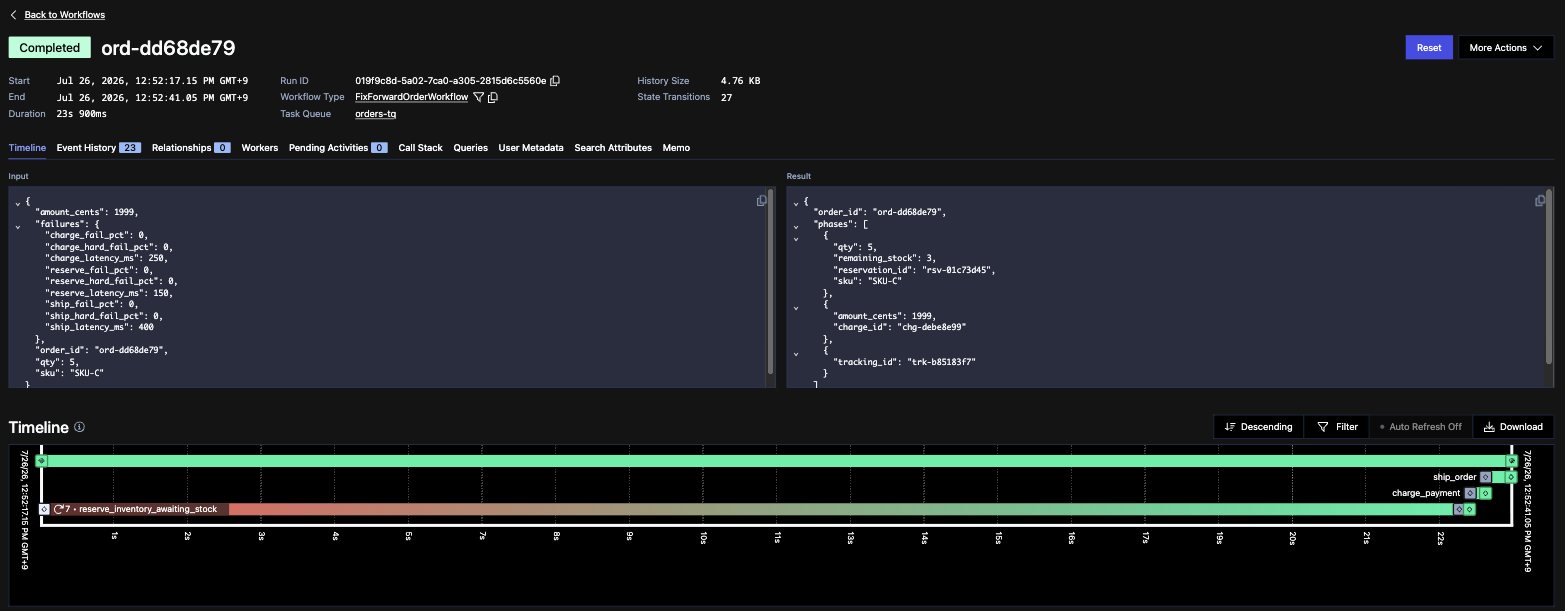
reserve가 ↺7번 재시도로 21초를 끌다가, 재고가 채워지자 charge·ship이 즉시 이어진다.다만 여기서 확인된 건 토이 시나리오에서의 fix-forward다. 진짜 시험은 이게 MVP를 넘어 실전에서도 버티는지다.
그래서 다음으로, 각 서비스의 이벤트를 중재하는 Orchestrator를 두고 이 durable execution 방식으로 굴리는 서비스를 직접 실험해 보려 한다. 앞 편에서 정리한 오케스트레이션 구조 위에, “실패하면 멈추고 → 원인을 고치고 → 그 지점부터 재개”를 실제로 붙여 보는 것이 목표다. 결과는 다음 글에서 이어서 기록하겠다.
답글 남기기