
이 글의 위치: 기술 블로그 → 백엔드 · 운영체제 개념.
작성·검증 방식은 Editorial Policy 를 참고하세요.
본문의 모든 수치는debian:bookworm-slim(커널 6.12.76-linuxkit aarch64, glibc 2.36, gcc 12.2.0) 컨테이너에서 직접 측정한 값입니다.
같은 문제를 정반대로 푸는 두 서버를 보고 생긴 질문
메일 서버들을 리눅스에서 띄워 보다가 이상한 대비를 발견했습니다. Postfix는 프로세스 여러 개를 띄우고 각각은 스레드가 1개인데, Haraka는 프로세스 2개에 스레드가 11개씩이었습니다. 같은 SMTP를 처리하는데 구조가 정반대입니다.
"프로세스는 격리되고 스레드는 공유한다"는 문장은 알고 있었지만, 그 문장이 리눅스에서 정확히 무엇을 뜻하는지 는 설명할 자신이 없었습니다. 무엇이 격리되고, 무엇이 공유되며, 그 경계는 누가 정하는가.
그래서 C 프로그램 하나를 짜서 컨테이너에서 돌려 봤습니다. 결론부터 적으면 이렇습니다. 리눅스 커널에게 프로세스와 스레드는 다른 종류가 아니라, 같은 것을 만들 때 켠 플래그가 다를 뿐입니다.
1. 커널이 만드는 것은 한 종류다
리눅스에는 "프로세스를 만드는 함수"와 "스레드를 만드는 함수"가 따로 있지 않습니다. 둘 다 clone() 하나로 갑니다. 확인해 봤습니다.
fork() 를 호출했을 때
$ strace -f -e trace=clone,clone3 ./isolation fork
clone(child_stack=NULL,
      flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD,
      child_tidptr=0xffff800b4050) = 659
pthread_create() 를 호출했을 때
$ strace -f -e trace=clone,clone3 ./isolation thread
clone(child_stack=0xffffaf4bea60,
      flags=CLONE_VM|CLONE_FS|CLONE_FILES|CLONE_SIGHAND|CLONE_THREAD
           |CLONE_SYSVSEM|CLONE_SETTLS|CLONE_PARENT_SETTID|CLONE_CHILD_CLEARTID,
      parent_tid=[666], tls=0xffffaf4bf8e0, child_tidptr=0xffffaf4bf270) = 666
같은 clone인데 플래그가 다릅니다. 그리고 이 플래그 목록이 사실상 "무엇을 공유할 것인가"의 체크리스트입니다.
| 플래그 | 켜면 공유되는 것 | fork | pthread |
|---|---|---|---|
CLONE_VM |
주소 공간(메모리) | ✗ | ✓ |
CLONE_FS |
작업 디렉터리·umask | ✗ | ✓ |
CLONE_FILES |
열린 파일 디스크립터 표 | ✗ | ✓ |
CLONE_SIGHAND |
시그널 핸들러 | ✗ | ✓ |
CLONE_THREAD |
같은 스레드 그룹(=같은 PID) | ✗ | ✓ |
CLONE_SYSVSEM |
System V 세마포어 | ✗ | ✓ |
CLONE_SETTLS |
스레드 로컬 저장소 설정 | ✗ | ✓ |
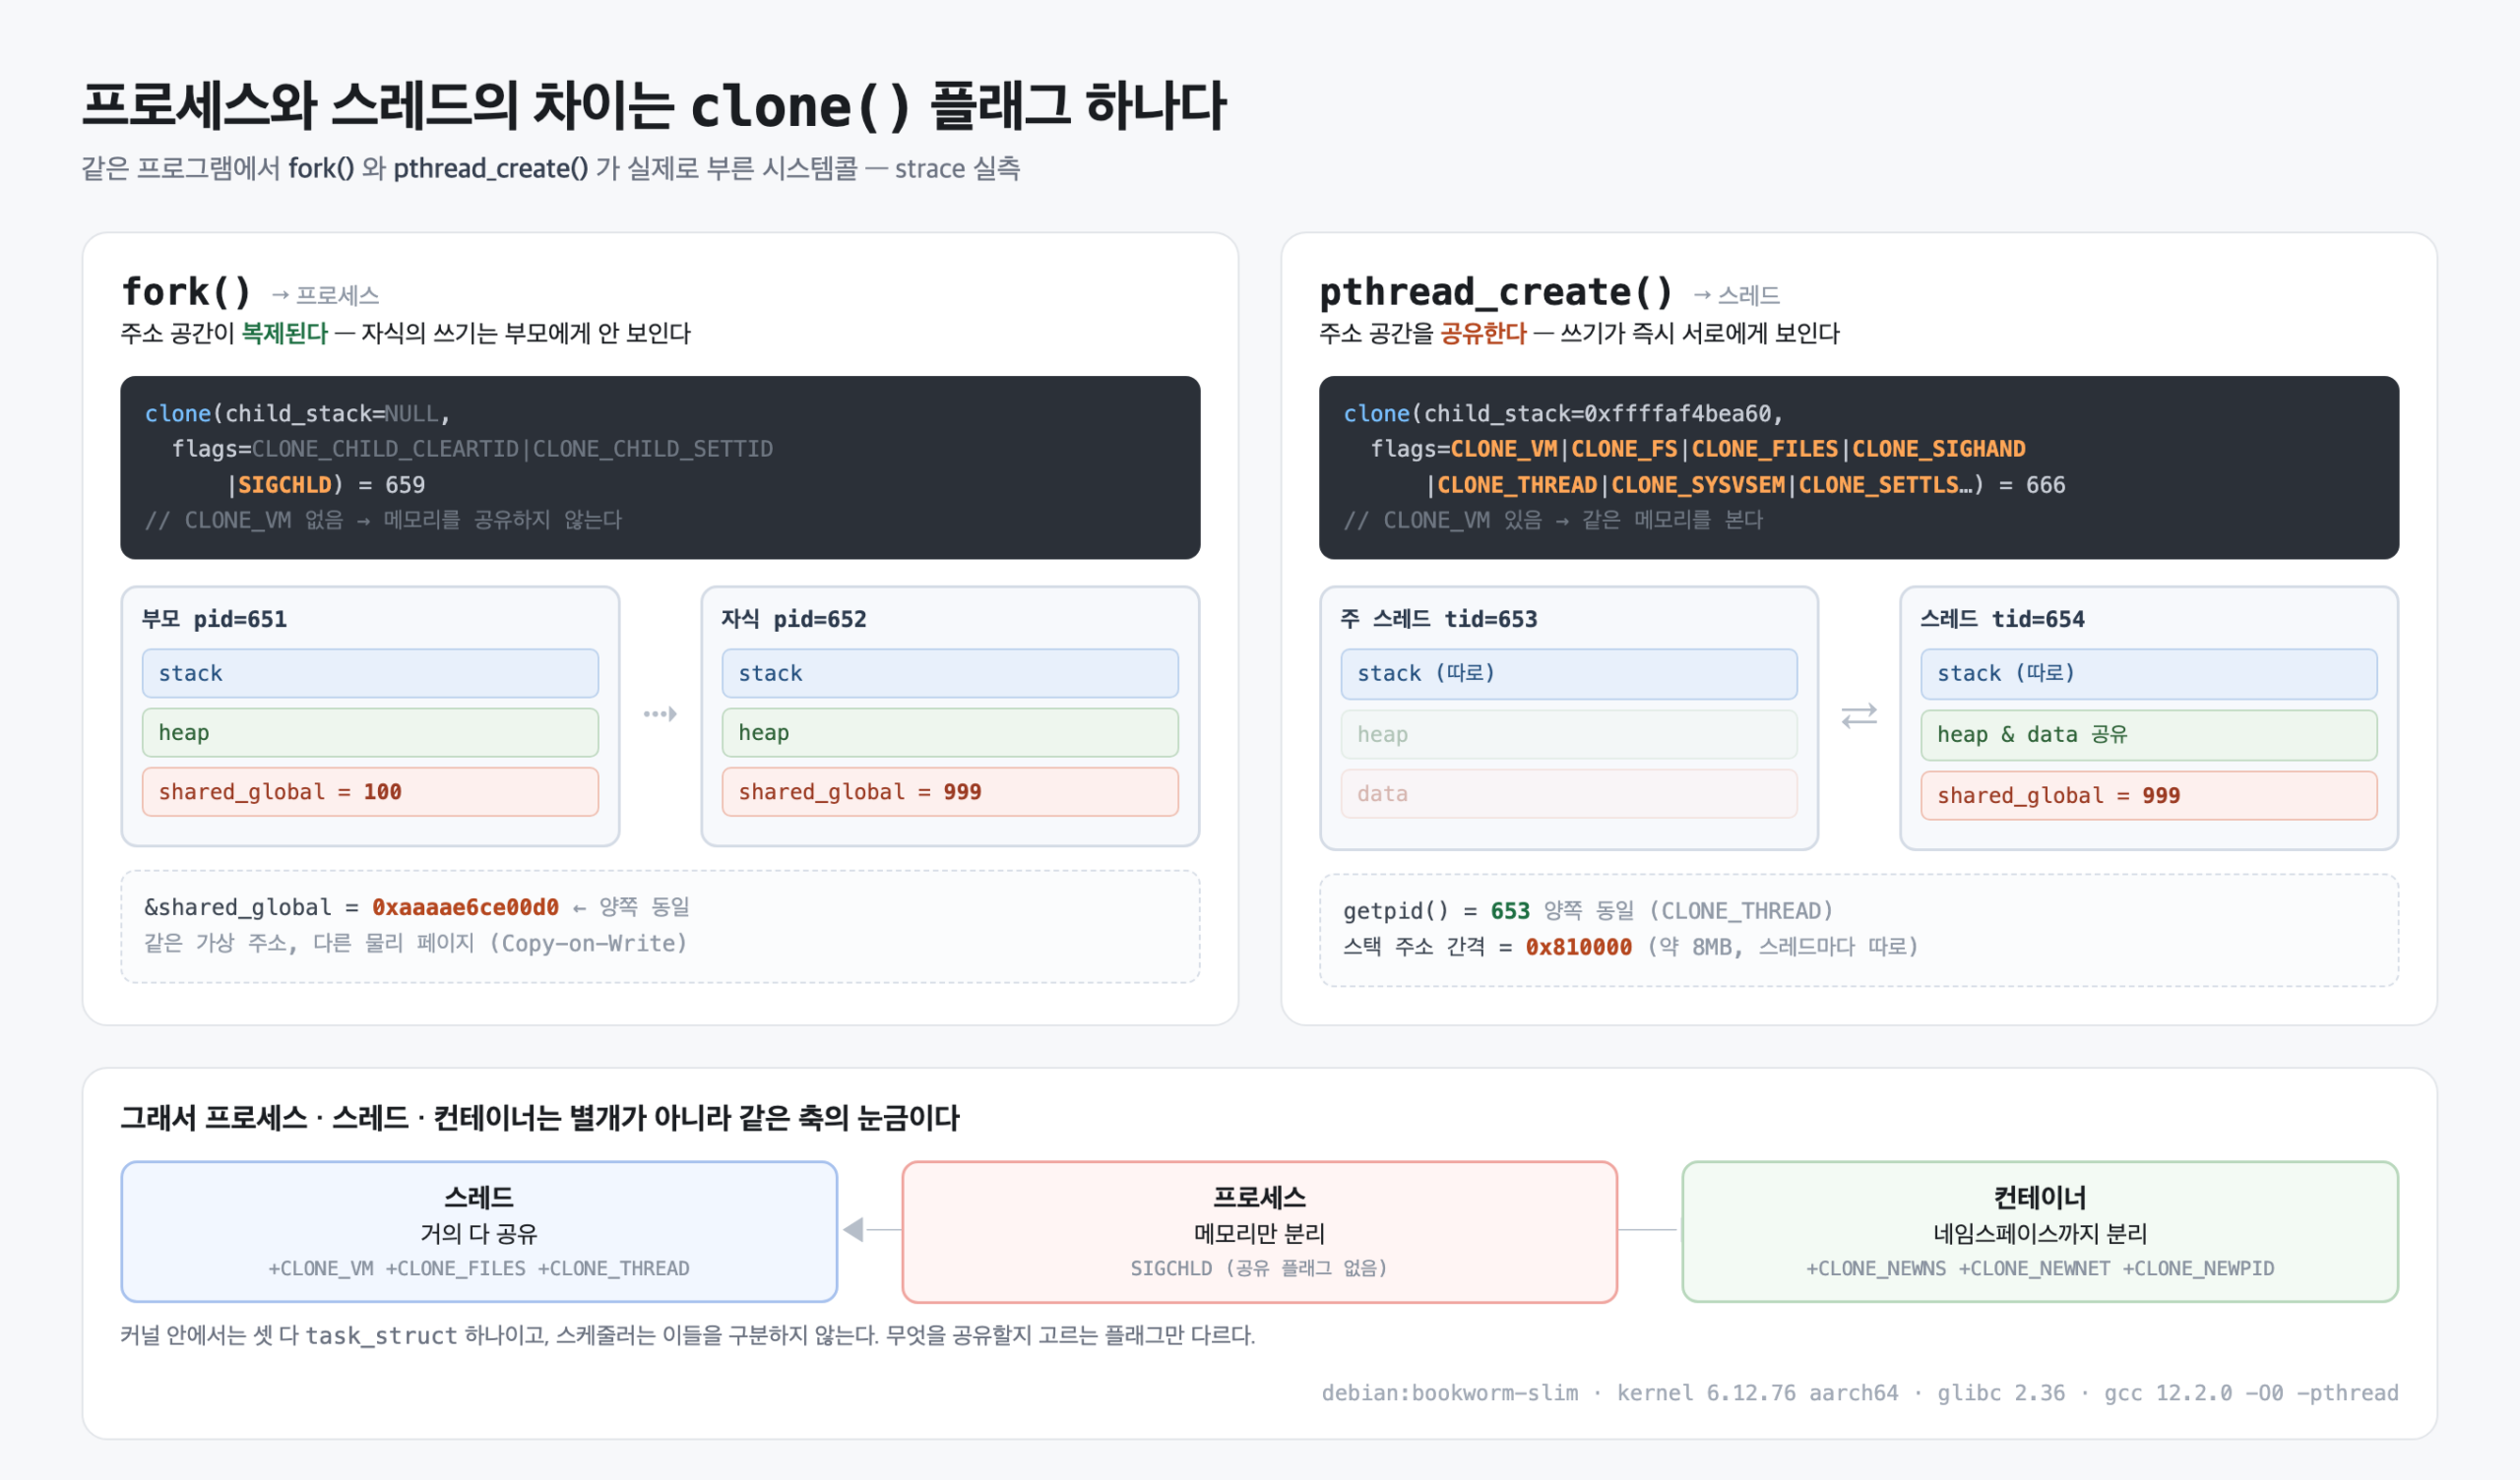
fork는 이 중 아무것도 켜지 않고 SIGCHLD만 붙였습니다. 즉 프로세스와 스레드의 차이는 종류의 차이가 아니라 플래그의 차이입니다. 커널 안에서 둘 다 task_struct 하나로 표현되고, 스케줄러도 이 둘을 구분하지 않고 똑같이 스케줄합니다.
그리고 이 플래그들이 켜고 끄는 대상이 연속적이라는 점이 중요합니다. 컨테이너는 여기에 CLONE_NEWNS·CLONE_NEWNET 같은 네임스페이스 플래그를 더 얹은 것뿐입니다. 프로세스 · 스레드 · 컨테이너는 별개의 개념이 아니라 같은 축 위의 눈금입니다.
2. 무엇이 격리되는가 — 주소 공간
플래그를 봤으니 실제로 데이터가 어떻게 갈리는지 확인할 차례입니다. 전역 변수 하나를 두고 자식이 바꿔 보게 했습니다.
static int shared_global = 100;
fork() 인 경우
[부모] 시작   shared_global=100  pid=651
[자식] 변경   shared_global=999  pid=652  &shared_global=0xaaaae6ce00d0
[부모] 이후   shared_global=100  pid=651  &shared_global=0xaaaae6ce00d0
자식이 999로 바꿨는데 부모는 여전히 100입니다. 그런데 여기서 눈여겨볼 게 있습니다. 부모와 자식이 출력한 변수의 주소가 0xaaaae6ce00d0 로 완전히 같습니다.
주소가 같은데 값이 다르다 — 이게 가상 메모리의 핵심입니다. 두 프로세스는 같은 가상 주소를 보지만 그 주소가 가리키는 물리 페이지가 다릅니다. 리눅스는 fork 시점에 메모리를 복사하지 않고 페이지를 읽기 전용으로 공유해 두었다가, 자식이 쓰는 순간에만 그 페이지를 복사합니다(Copy-on-Write). 위 출력은 그 복사가 일어난 직후의 모습입니다.
pthread_create() 인 경우
[주스레드] 시작 shared_global=100  pid=653 tid=653
[스레드] 변경   shared_global=999  tid=654  &shared_global=0xaaaaacb600d0
[주스레드] 이후 shared_global=999  pid=653 tid=653  &shared_global=0xaaaaacb600d0
이번엔 그대로 보입니다. CLONE_VM이 켜져 있어 주소 공간이 하나뿐이니, 같은 주소는 같은 물리 페이지입니다.
곁가지 하나. 처음 이 실험을 돌렸을 때 자식의 출력이 통째로 사라졌습니다. 원인은
fork가 stdio 버퍼까지 복제하는데 자식이_exit()로 끝나면서 버퍼를 비우지 않았기 때문이었습니다. 반대로fork전에 버퍼를 안 비우면 부모가 이미 찍은 줄이 자식에게도 남아 같은 줄이 두 번 나옵니다. "복제된다"는 말의 범위가 생각보다 넓다는 걸 여기서 실감했습니다.
3. 스레드는 PID를 공유하고 스택만 따로 갖는다
스레드 4개를 만들고 식별자와 스택 주소를 찍어 봤습니다.
주 스레드   getpid()=1  gettid()=1
  스레드 0  getpid()=1  gettid()=689  스택변수 주소=0xffffabf7e938
  스레드 1  getpid()=1  gettid()=690  스택변수 주소=0xffffab76e938
  스레드 2  getpid()=1  gettid()=691  스택변수 주소=0xffffaaf5e938
  스레드 3  getpid()=1  gettid()=692  스택변수 주소=0xffffaa74e938

/proc/1/task = 1 689 690 691 692
세 가지가 한눈에 보입니다.
getpid()는 전부 1로 같습니다.CLONE_THREAD때문입니다. 커널이 실제로 스케줄하는 단위는gettid()가 돌려주는 TID이고, PID는 그 스레드들이 속한 그룹의 대표 번호(TGID)입니다.ps가 기본으로 보여 주는 건 TID가 아니라 이 TGID라서, 스레드가 많은 프로세스도 한 줄로만 보입니다./proc/<pid>/task아래에 스레드가 전부 노출됩니다. 앞선 글에서 Haraka의 스레드 11개를 센 것이 바로 이 디렉터리입니다.- 스택 주소 간격이 정확히
0x810000(약 8MB) 입니다. 스레드마다 기본 스택(8MB,ulimit -s)이 따로 할당된다는 뜻입니다.
정리하면 스레드 사이에서 전역·힙은 공유되고 스택은 분리됩니다. 지역 변수가 안전한 이유가 이것이고, 전역과 힙을 만질 때만 조심하면 되는 이유도 이것입니다.
4. 공유의 대가 — 카운터의 73%가 사라졌다
공유가 편하다는 건 곧 서로를 밟을 수 있다는 뜻입니다. 스레드 N개가 각각 100만 번씩 공유 카운터를 1씩 올리게 했습니다. 보호 장치는 없습니다.
for (long i = 0; i < 1000000; i++) counter++;
race   threads=2  기대값=2000000  실제=1012591  손실=987409  (49.37%)   3.0 ms
race   threads=4  기대값=4000000  실제=1095089  손실=2904911 (72.62%)   3.6 ms
race   threads=8  기대값=8000000  실제=2148420  손실=5851580 (73.14%)   9.5 ms
8스레드에서 증가 연산의 73%가 증발했습니다. 이따금 어긋나는 정도가 아니라 대부분이 사라진 겁니다.
counter++ 는 소스에서 한 줄이지만 기계어에서는 읽고 → 더하고 → 쓰는 세 단계입니다. 두 스레드가 같은 값을 읽어 각자 1을 더해 쓰면, 두 번 올렸는데 결과는 1만 오릅니다. 스레드가 늘수록 겹치는 창이 넓어져 손실률이 올라갑니다.
여기서 조심할 만한 지점이 하나 있습니다. 2스레드에서도 이미 49%가 날아갔다는 것. "경쟁 조건은 드물게 터지는 사고"라는 인상은 사실과 다릅니다. 보호가 없으면 기본값이 실패입니다. 테스트에서 안 잡히는 건 드물어서가 아니라 대개 부하가 낮아서입니다.
5. 뮤텍스 — 잃어버린 격리를 소프트웨어로 되사오기
같은 코드를 pthread_mutex_lock/unlock 으로 감쌌습니다.
mutex  threads=2  기대값=2000000  실제=2000000  손실=0 (0.00%)   39.6 ms
mutex  threads=4  기대값=4000000  실제=4000000  손실=0 (0.00%)  103.4 ms
mutex  threads=8  기대값=8000000  실제=8000000  손실=0 (0.00%)  243.7 ms
손실이 정확히 0이 됐습니다. 대신 대가가 붙었습니다.
| 스레드 | race(틀림) | mutex(맞음) | 시간 배수 |
|---|---|---|---|
| 2 | 3.0 ms | 39.6 ms | 13배 |
| 4 | 3.6 ms | 103.4 ms | 29배 |
| 8 | 9.5 ms | 243.7 ms | 26배 |
그리고 더 눈여겨볼 것은 뮤텍스 쪽이 스레드를 늘려도 빨라지지 않는다는 점입니다. 2 → 8스레드로 4배를 늘렸는데 시간은 39.6 → 243.7ms로 오히려 6배가 됐습니다. 임계 구역이 직렬화되니 병렬성은 사라지고 경합 비용만 남습니다. 코어를 더 준다고 해결되지 않는 종류의 벽입니다.
여기서 뮤텍스의 정체가 드러납니다. 뮤텍스는 스레드가 공유해서 잃어버린 격리를, 시간 축에서 다시 만들어 내는 장치입니다. 프로세스는 공간으로 격리하고(주소 공간 분리), 뮤텍스는 시간으로 격리합니다(한 번에 하나만 들어감). 그래서 뮤텍스를 걸수록 코드는 프로세스 모델에 가까운 직렬 실행에 수렴합니다.
6. 리눅스에서 뮤텍스는 futex로 만들어진다
뮤텍스를 걸 때마다 커널에 들어간다면 저 숫자보다 훨씬 느렸을 겁니다. 실제로 시스템콜이 몇 번 불리는지 셌습니다.
$ strace -f -c -e trace=futex ./isolation race 8 200000
% time     seconds  usecs/call     calls    errors syscall
  0.00    0.000000           0         4           futex      ← 4번

$ strace -f -c -e trace=futex ./isolation mutex 8 200000
% time     seconds  usecs/call     calls    errors syscall
100.00    0.088752          37      2385       704 futex      ← 2,385번
뮤텍스를 쓴 쪽은 futex 를 2,385번 불렀고, 안 쓴 쪽은 4번(스레드 종료를 기다리는 pthread_join 몫)뿐이었습니다.
중요한 건 160만 번의 lock/unlock에 비해 2,385번은 대단히 적다는 사실입니다. futex(fast userspace mutex)는 이름 그대로, 경합이 없으면 사용자 공간에서 원자적 연산만으로 끝내고 커널로 내려가지 않습니다. 커널을 부르는 건 이미 잠긴 락을 만나 재우거나 깨울 때뿐입니다. 2,385번은 실제로 부딪힌 횟수인 셈입니다.
errors 704 도 정상입니다. 재우려는 순간 락 상태가 이미 바뀌어 있으면 커널이 EAGAIN을 돌려주고, glibc는 다시 시도합니다. 오류가 아니라 낙관적 재시도의 흔적입니다.
측정 환경이 aarch64라는 점도 한 번 짚어 둘 만합니다. ARM은 x86보다 메모리 순서 보장이 약해서, 원자적 연산과 메모리 배리어의 비용·필요성이 더 두드러집니다. 같은 코드의 손실률은 CPU 아키텍처에 따라 달라질 수 있습니다.
7. 그래서 무엇을 고르나
처음 질문으로 돌아갑니다. Postfix는 왜 프로세스를 나누고 Haraka는 왜 스레드를 쓰나.
| 프로세스로 나눈다 | 스레드로 나눈다 | |
|---|---|---|
| 데이터 | 기본 격리(따로 안 지켜도 안전) | 기본 공유(직접 지켜야 안전) |
| 생성 비용 | 큼(주소 공간 세팅, CoW) | 작음 |
| 통신 | 파이프·소켓·공유메모리 — 명시적 | 그냥 변수 — 암묵적 |
| 하나가 죽으면 | 그 프로세스만 죽음 | 전체가 같이 죽음 |
| 권한 | 프로세스마다 다른 사용자 가능 | 전부 같은 권한 |
| 디버깅 | 경계가 눈에 보임 | 경쟁 조건은 재현이 어려움 |
| 맞는 경우 | 신뢰 경계가 다를 때 | 상태를 자주 공유할 때 |
Postfix가 프로세스를 고른 이유가 표의 마지막 두 줄에 있습니다. 외부 입력을 직접 만지는 smtpd 와 큐를 만지는 qmgr 는 신뢰 수준이 다릅니다. 스레드로 묶으면 하나가 뚫렸을 때 전부 뚫리고, 하나가 죽으면 전부 죽습니다. 성능을 조금 내주고 격리를 산 선택입니다.
Haraka가 스레드(정확히는 단일 이벤트 루프)를 고른 이유도 같은 표로 설명됩니다. SMTP 세션은 대부분 네트워크 대기입니다. 대기하는 동안 CPU를 쓰지 않으니 스레드를 늘릴 이유가 없고, 커넥션 상태를 한 힙에 두면 플러그인이 자유롭게 만질 수 있습니다. 대신 플러그인 하나가 이벤트 루프를 막으면 전체가 멈춥니다. 그래서 Haraka는 워커 프로세스 복제를 권합니다 — 결국 프로세스로 돌아옵니다.
실무에서 제가 쓰는 판단 순서는 이렇습니다.
- 신뢰 경계나 장애 경계가 다른가? → 프로세스(또는 파드)로 나눈다.
- 공유 상태가 꼭 필요한가? → 아니라면 아예 나누어 뮤텍스를 없앤다. 가장 빠른 락은 걸지 않은 락입니다.
- 공유가 불가피한가? → 임계 구역을 최소로 줄인다. 위 실험에서 임계 구역은
counter++한 줄이었는데도 26배가 붙었습니다. - 읽기가 압도적인가? → RWLock이나 스레드 로컬 누적 후 합산을 검토한다.
이 판단은 스레드에서 끝나지 않고 그대로 위층으로 이어집니다. 여러 파드가 한 자원을 다툴 때 쓰는 분산 락도, 커넥션 풀이 커넥션을 나눠 주는 방식도 결국 같은 문제입니다. 커넥션 풀 크기를 정하는 공식이 코어 수와 대기 시간으로 이루어져 있는 것도, 채팅 서버에서 느린 클라이언트 하나가 방 전체를 막지 않게 워커를 나눈 것도 같은 표의 다른 층입니다.
8. 정리
- 리눅스에서 프로세스와 스레드는 다른 것이 아니라
clone()플래그가 다른 것입니다. 실제로fork는SIGCHLD만,pthread_create는CLONE_VM|CLONE_FS|CLONE_FILES|CLONE_SIGHAND|CLONE_THREAD|…를 켭니다. - 격리의 실체는
CLONE_VM하나입니다. 이게 꺼지면 같은 가상 주소가 다른 물리 페이지를 가리키고(CoW), 켜지면 같은 페이지를 가리킵니다. - 스레드는 PID(TGID)를 공유하고 스택만 8MB 간격으로 따로 갖습니다. 전역·힙은 공유됩니다.
- 공유의 대가는 실측으로 8스레드에서 증가 연산의 73% 손실이었습니다. 경쟁 조건은 희귀 사고가 아니라 보호가 없을 때의 기본값입니다.
- 뮤텍스는 잃어버린 격리를 시간 축에서 되사오는 장치입니다. 정확도는 100%가 되지만 26배 느려졌고, 스레드를 늘려도 빨라지지 않았습니다.
- 리눅스의 뮤텍스는 futex 로, 경합이 없으면 커널에 들어가지 않습니다. 160만 번의 lock 중 커널 호출은 2,385번뿐이었습니다.
"프로세스는 격리되고 스레드는 공유한다"는 문장은 맞았지만, 그 문장이 플래그 하나로 켜고 끄는 연속적인 축이라는 건 직접 재보기 전에는 몰랐습니다. 그리고 그 축의 더 위쪽 눈금에 네임스페이스와 컨테이너가 있습니다.
함께 읽으면 좋은 글:
- [메일 인프라] Postfix·OpenSMTPD·Haraka는 각각 무엇을 맡나 — 이 글이 시작된 곳. 세 MTA의 프로세스 트리 실측
- [채팅 백엔드 설계] 느린 클라이언트 하나가 방 전체를 막지 않게 — 이벤트 루프가 막히는 문제를 실제 서비스에서 다룬 기록
- [설계 판단] 커넥션 풀 크기는 무엇으로 정하는가 — 같은 동시성 문제의 풀 계층 버전
참고 (1차 출처)
- Linux man-pages —
clone(2),futex(2),gettid(2),pthreads(7),proc(5) - Ulrich Drepper, Futexes Are Tricky
- 측정 환경:
debian:bookworm-slim/ 커널 6.12.76-linuxkit aarch64 / glibc 2.36 / gcc 12.2.0-O0 -pthread/ Docker 29.5.3
답글 남기기