
집에 굴리는 서버 PC 한 대에 관측성(Observability) 스택을 세우고, 거기서 출발해 보안 게이팅과 GitOps까지 밀어붙인 기록이다. 원래 여섯 편으로 나눠 적었던 글인데, 읽어보니 하나의 연속된 삽질기라 한 편으로 합쳤다. 중간에 실패한 시도(eBPF)도 성공한 것과 같은 비중으로 남겨 두었다.
전체 흐름은 이렇다.
- 스택 세우기 — Prometheus·Loki·Tempo·Grafana를 디스크 14GB 제약 안에서
- 대시보드 3종 — 같은 데이터로 Pinpoint·Datadog·표준(RED/USE) 시선을 재현
- 런타임 갭 — Compose 관측 스택이 k3s 파드를 못 보던 문제, k8s-네이티브 전환
- RED 확보 — eBPF(Beyla) 실패, 서비스메시(Linkerd)로 우회
- 보안 게이팅 — Cloudflare Access로 관측 도메인 앞단 인증
- GitOps 편입 — 라이브 서비스를 깨지 않고 ArgoCD로
서버는 i5-4690 / 32GB RAM, 루트 파티션 여유는 14GB. 이 제약이 뒤의 모든 결정을 좌우했다.
1. 홈서버에 관측성 스택 세우기 — Prometheus·Loki·Tempo·Grafana
먼저 바닥부터 깐다. 이 단계의 결정을 좌우한 건 성능이 아니라 남은 디스크 용량이었다.
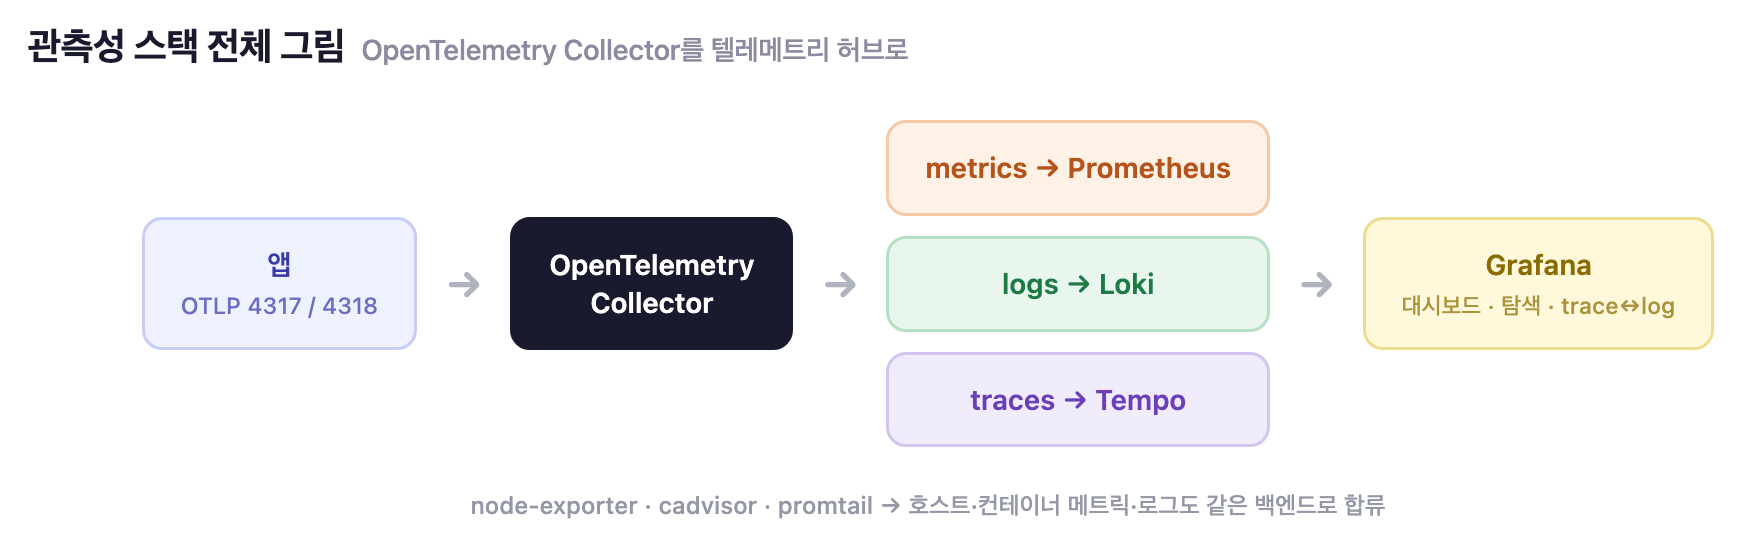
목표는 단순하다. “무슨 일이 일어나는지 보이게” 만들기 — 메트릭(Prometheus), 로그(Loki), 추적(Tempo), 그리고 그것을 한 화면에서 보는 대시보드(Grafana). 여기에 텔레메트리 허브로 OpenTelemetry Collector를 얹었다.
그런데 이걸 매번 손으로 깔면 다음에 또 헤맨다. 그래서 Claude Code 스킬(SOT, Source of Truth) 로 코드화해서, 명령 한 번으로 렌더 → 기동 → 헬스 동기화까지 끝나게 만들었다.
전체 그림
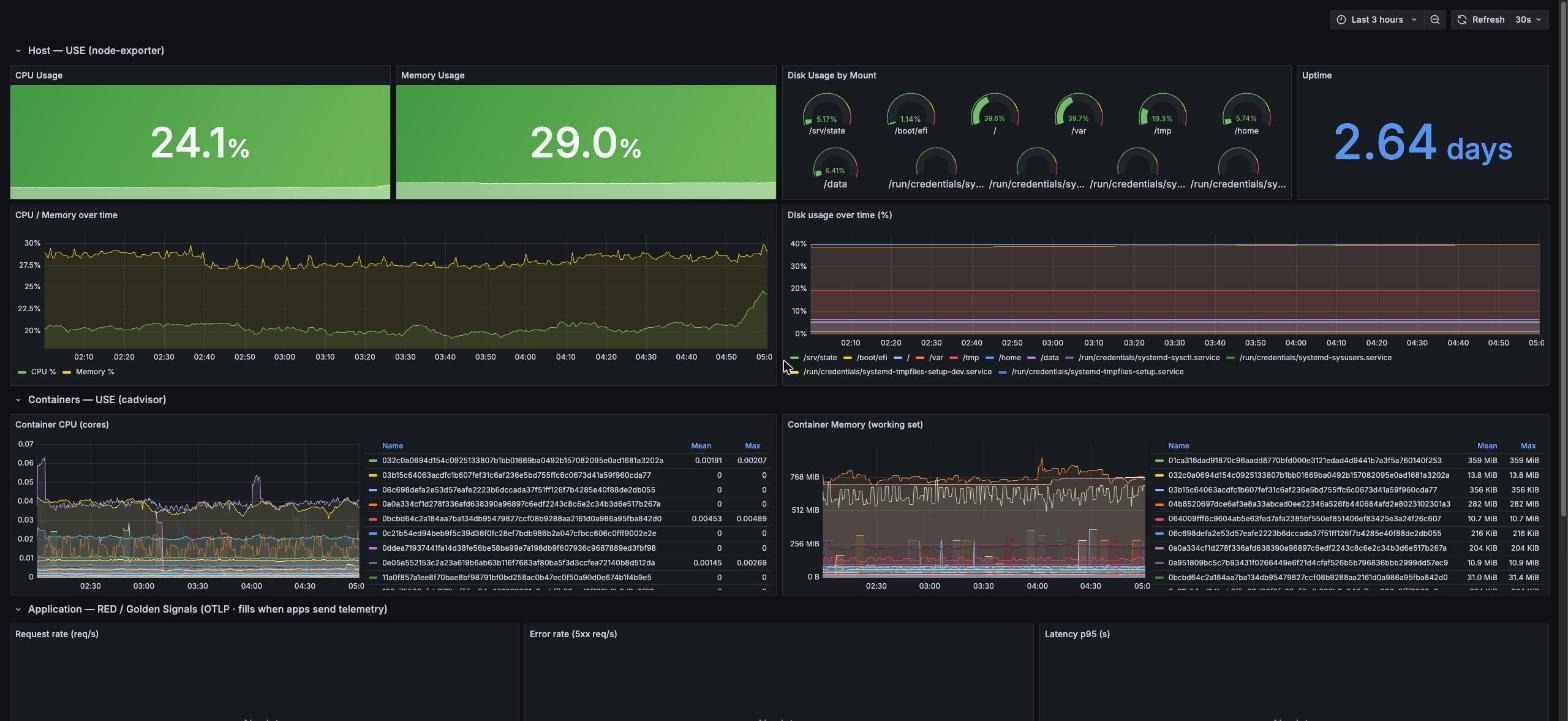
용량이 빠듯한 서버 — 디스크 정책이 핵심
이 PC는 루트 파티션이 14GB밖에 안 남았다. 그래서 처음부터 디스크 최소 원칙을 박아넣었다.
- 짧은 보존창: Prometheus 72h(+512MB 상한), Loki 72h, Tempo 48h
- 백업 없음 · 오브젝트 스토리지 없음 — 전부 로컬 파일시스템
- 데이터 볼륨은 여유 있는
/home(831GB)에 bind-mount — Docker 기본 named volume이 루트를 채우는 사고 방지
리소스 점유 — 생각보다 가볍다
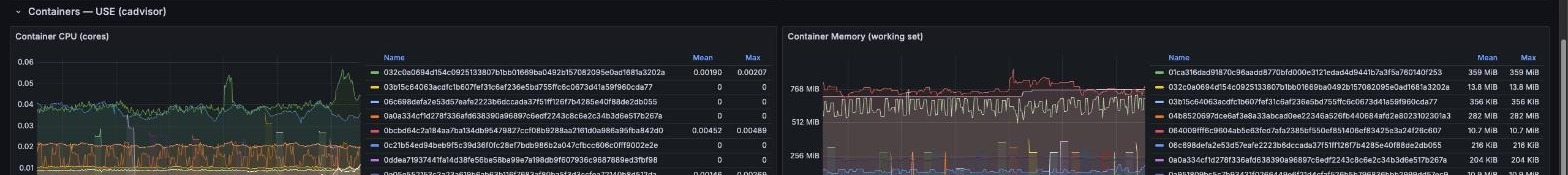
i5-4690 / 32GB RAM 서버에서, 관측 스택 9개 컨테이너가 잡아먹은 자원은 메모리 ~1.4%(약 0.6GiB), CPU ~2%. 관측 데이터도 며칠 지나면 보존창 덕에 평형에 도달한다. (아래 실측은 이후 k8s로 이주(관측 #3)한 뒤 같은 스택을 잰 스냅숏이다.)
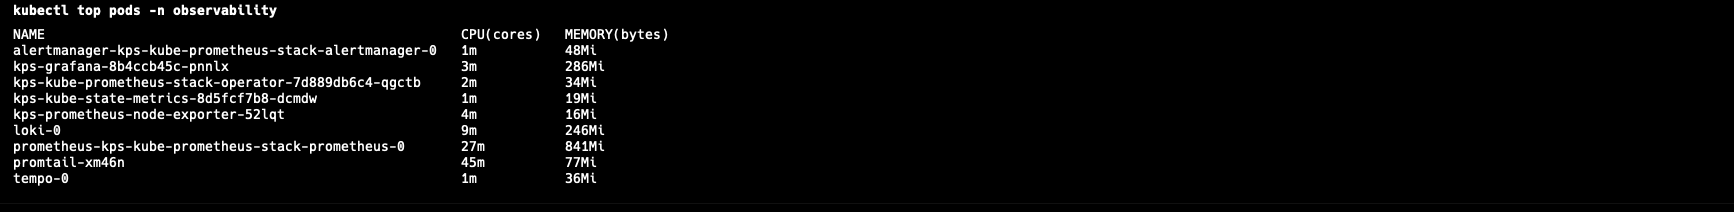
kubectl top pods -n observability. kube-prometheus-stack이라 Prometheus가 841Mi로 가장 크지만, 32GB 서버엔 여전히 가볍다2. 같은 데이터로 APM 대시보드 3종 — Pinpoint·Datadog·표준
스택이 서고 나니 질문이 옮겨갔다. 무엇을 먼저 띄울 것인가.
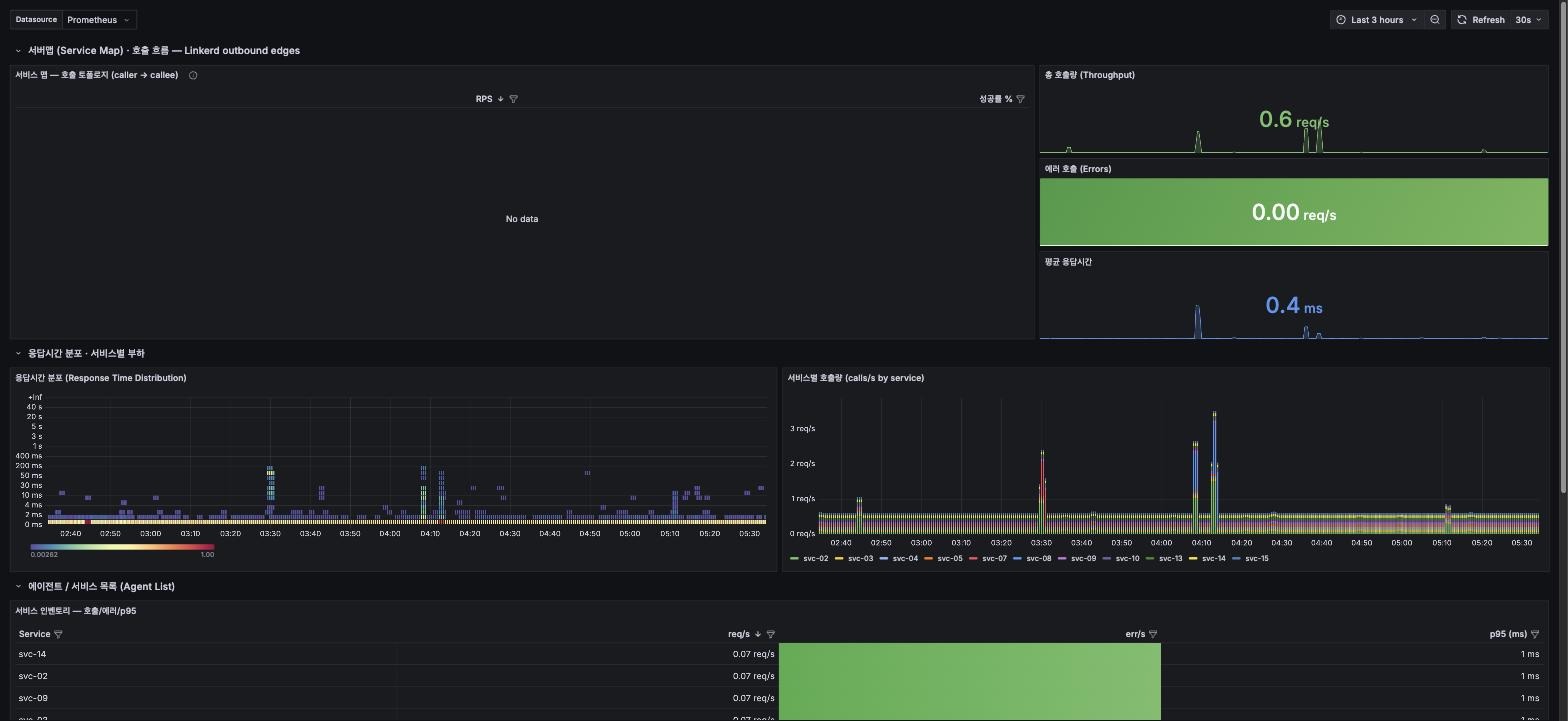
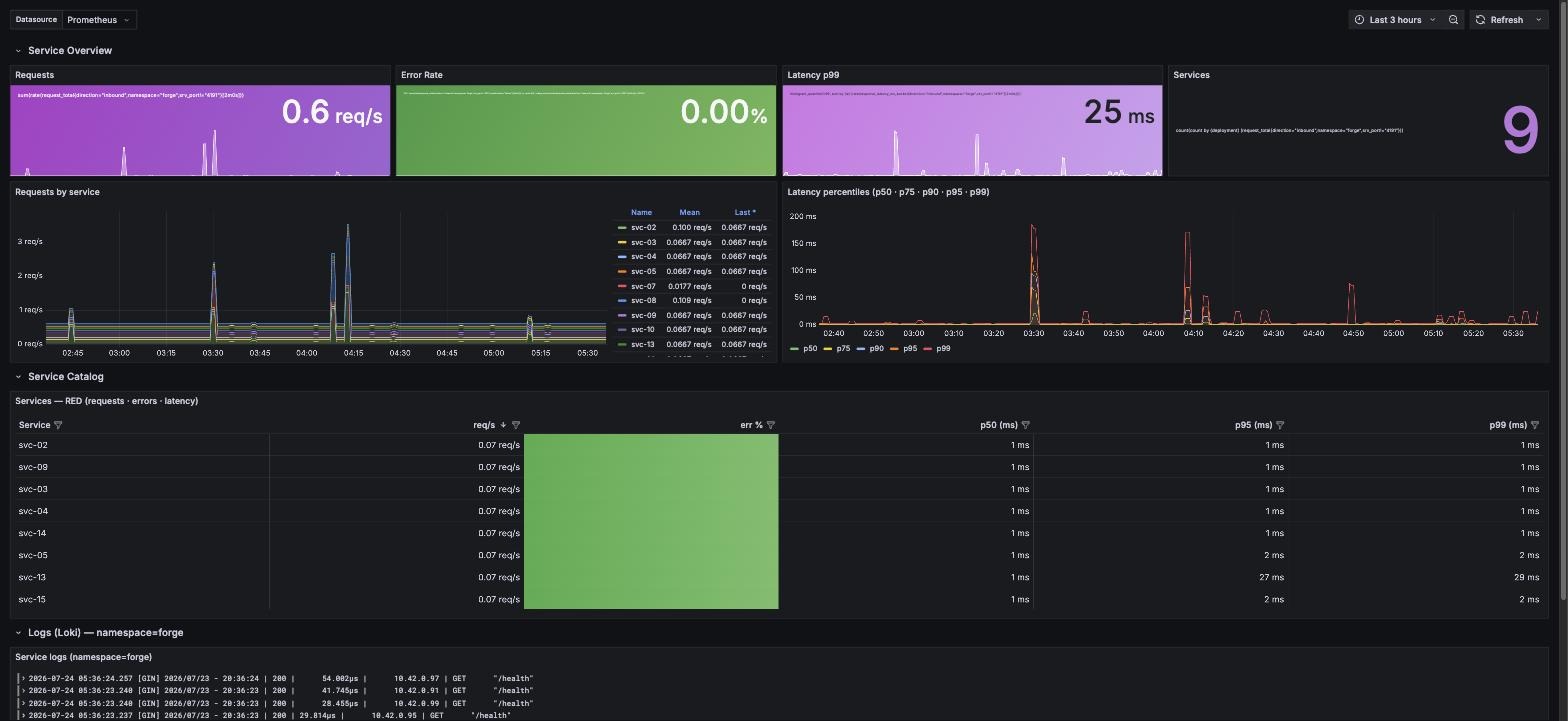
관측이 되기 시작하니 욕심이 생겼다. 유명 APM들의 화면을 같은 데이터로 재현해보자. Naver Pinpoint(서버맵 중심), Datadog(RED 카탈로그), 그리고 표준 RED/USE(Golden Signals). 세 대시보드가 동일한 트레이스+로그 스트림을 조회하고, 화면 스타일만 다르게.
어떻게 같은 데이터로?
핵심은 Tempo metrics-generator다. 트레이스에서 span-metrics(RED)와 service-graph(서버맵 엣지)를 뽑아 Prometheus로 remote-write한다. 그러면 세 스타일 모두 이 메트릭을 조회한다.
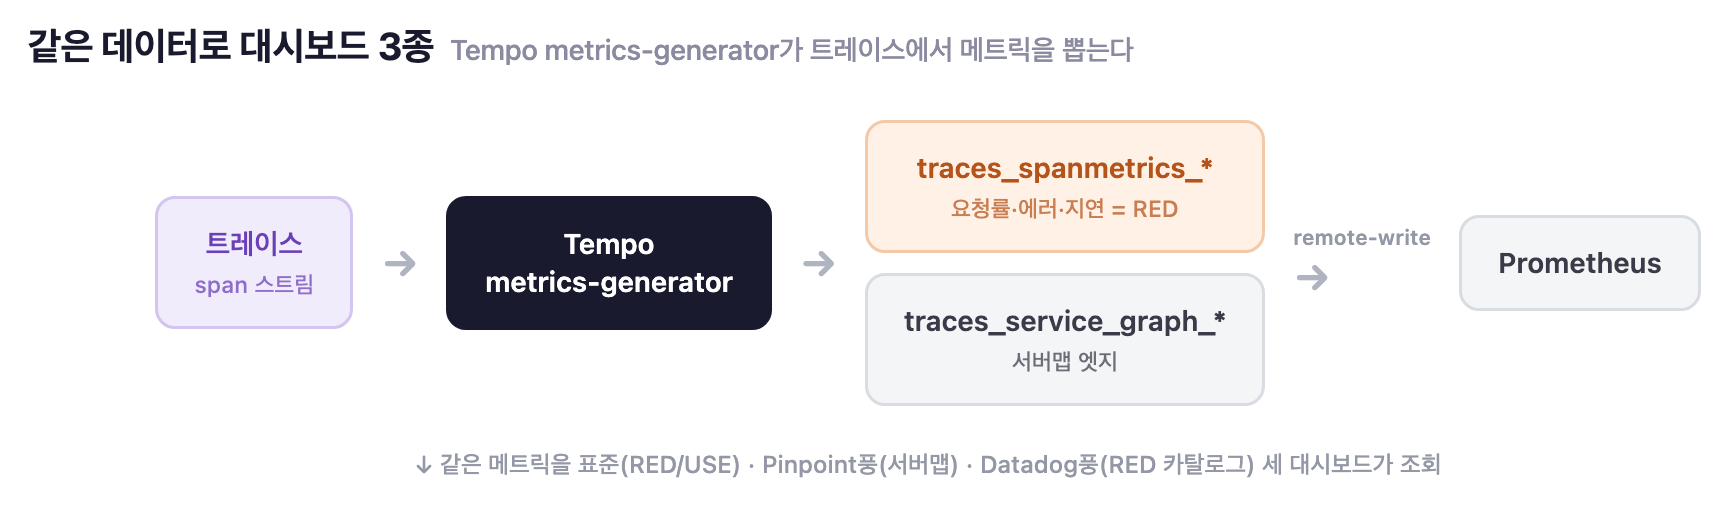
‘원본을 베끼기’가 아니라 ‘시선을 옮겨두기’
상용 APM 화면을 그대로 가져올 수는 없다. 대신 각 도구가 데이터를 무엇부터 보여주는가 — 그 시선을 공부해, 같은 데이터 위에 같은 Style로 얹어 두었다. 원본 스크린샷 대신 공식 문서가 설명하는 ‘일반적인 사용 방식’을 옆에 두고, 내 재현이 같은 순서로 읽히는지 맞춰봤다.
Pinpoint의 시선 — 토폴로지 먼저. Pinpoint는 서버맵으로 구성요소가 어떻게 연결돼 있는지를 먼저 보여주고, 노드를 누르면 상태·트랜잭션 수가 열린다. 응답시간도 스캐터 대신 히트맵으로 통계적으로 요약해 한눈에 훑게 한다. 내 재현도 caller→callee 엣지 테이블과 응답시간 히트맵을 상단에 둬 ‘흐름부터’ 읽히게 했다. (참고: Pinpoint 공식 개요)
Datadog의 시선 — 서비스 지표 먼저. Datadog은 서비스 페이지에서 요청·에러·지연(p50~p99)을 100% 트래픽 기준으로 먼저 세우고, 카탈로그에서 서비스별 RED를 정렬한다. 내 재현은 퍼플 RED 타일·퍼센타일·서비스 카탈로그·Loki 로그를 같은 순서로 배치했다. (참고: Datadog Service Page 문서)
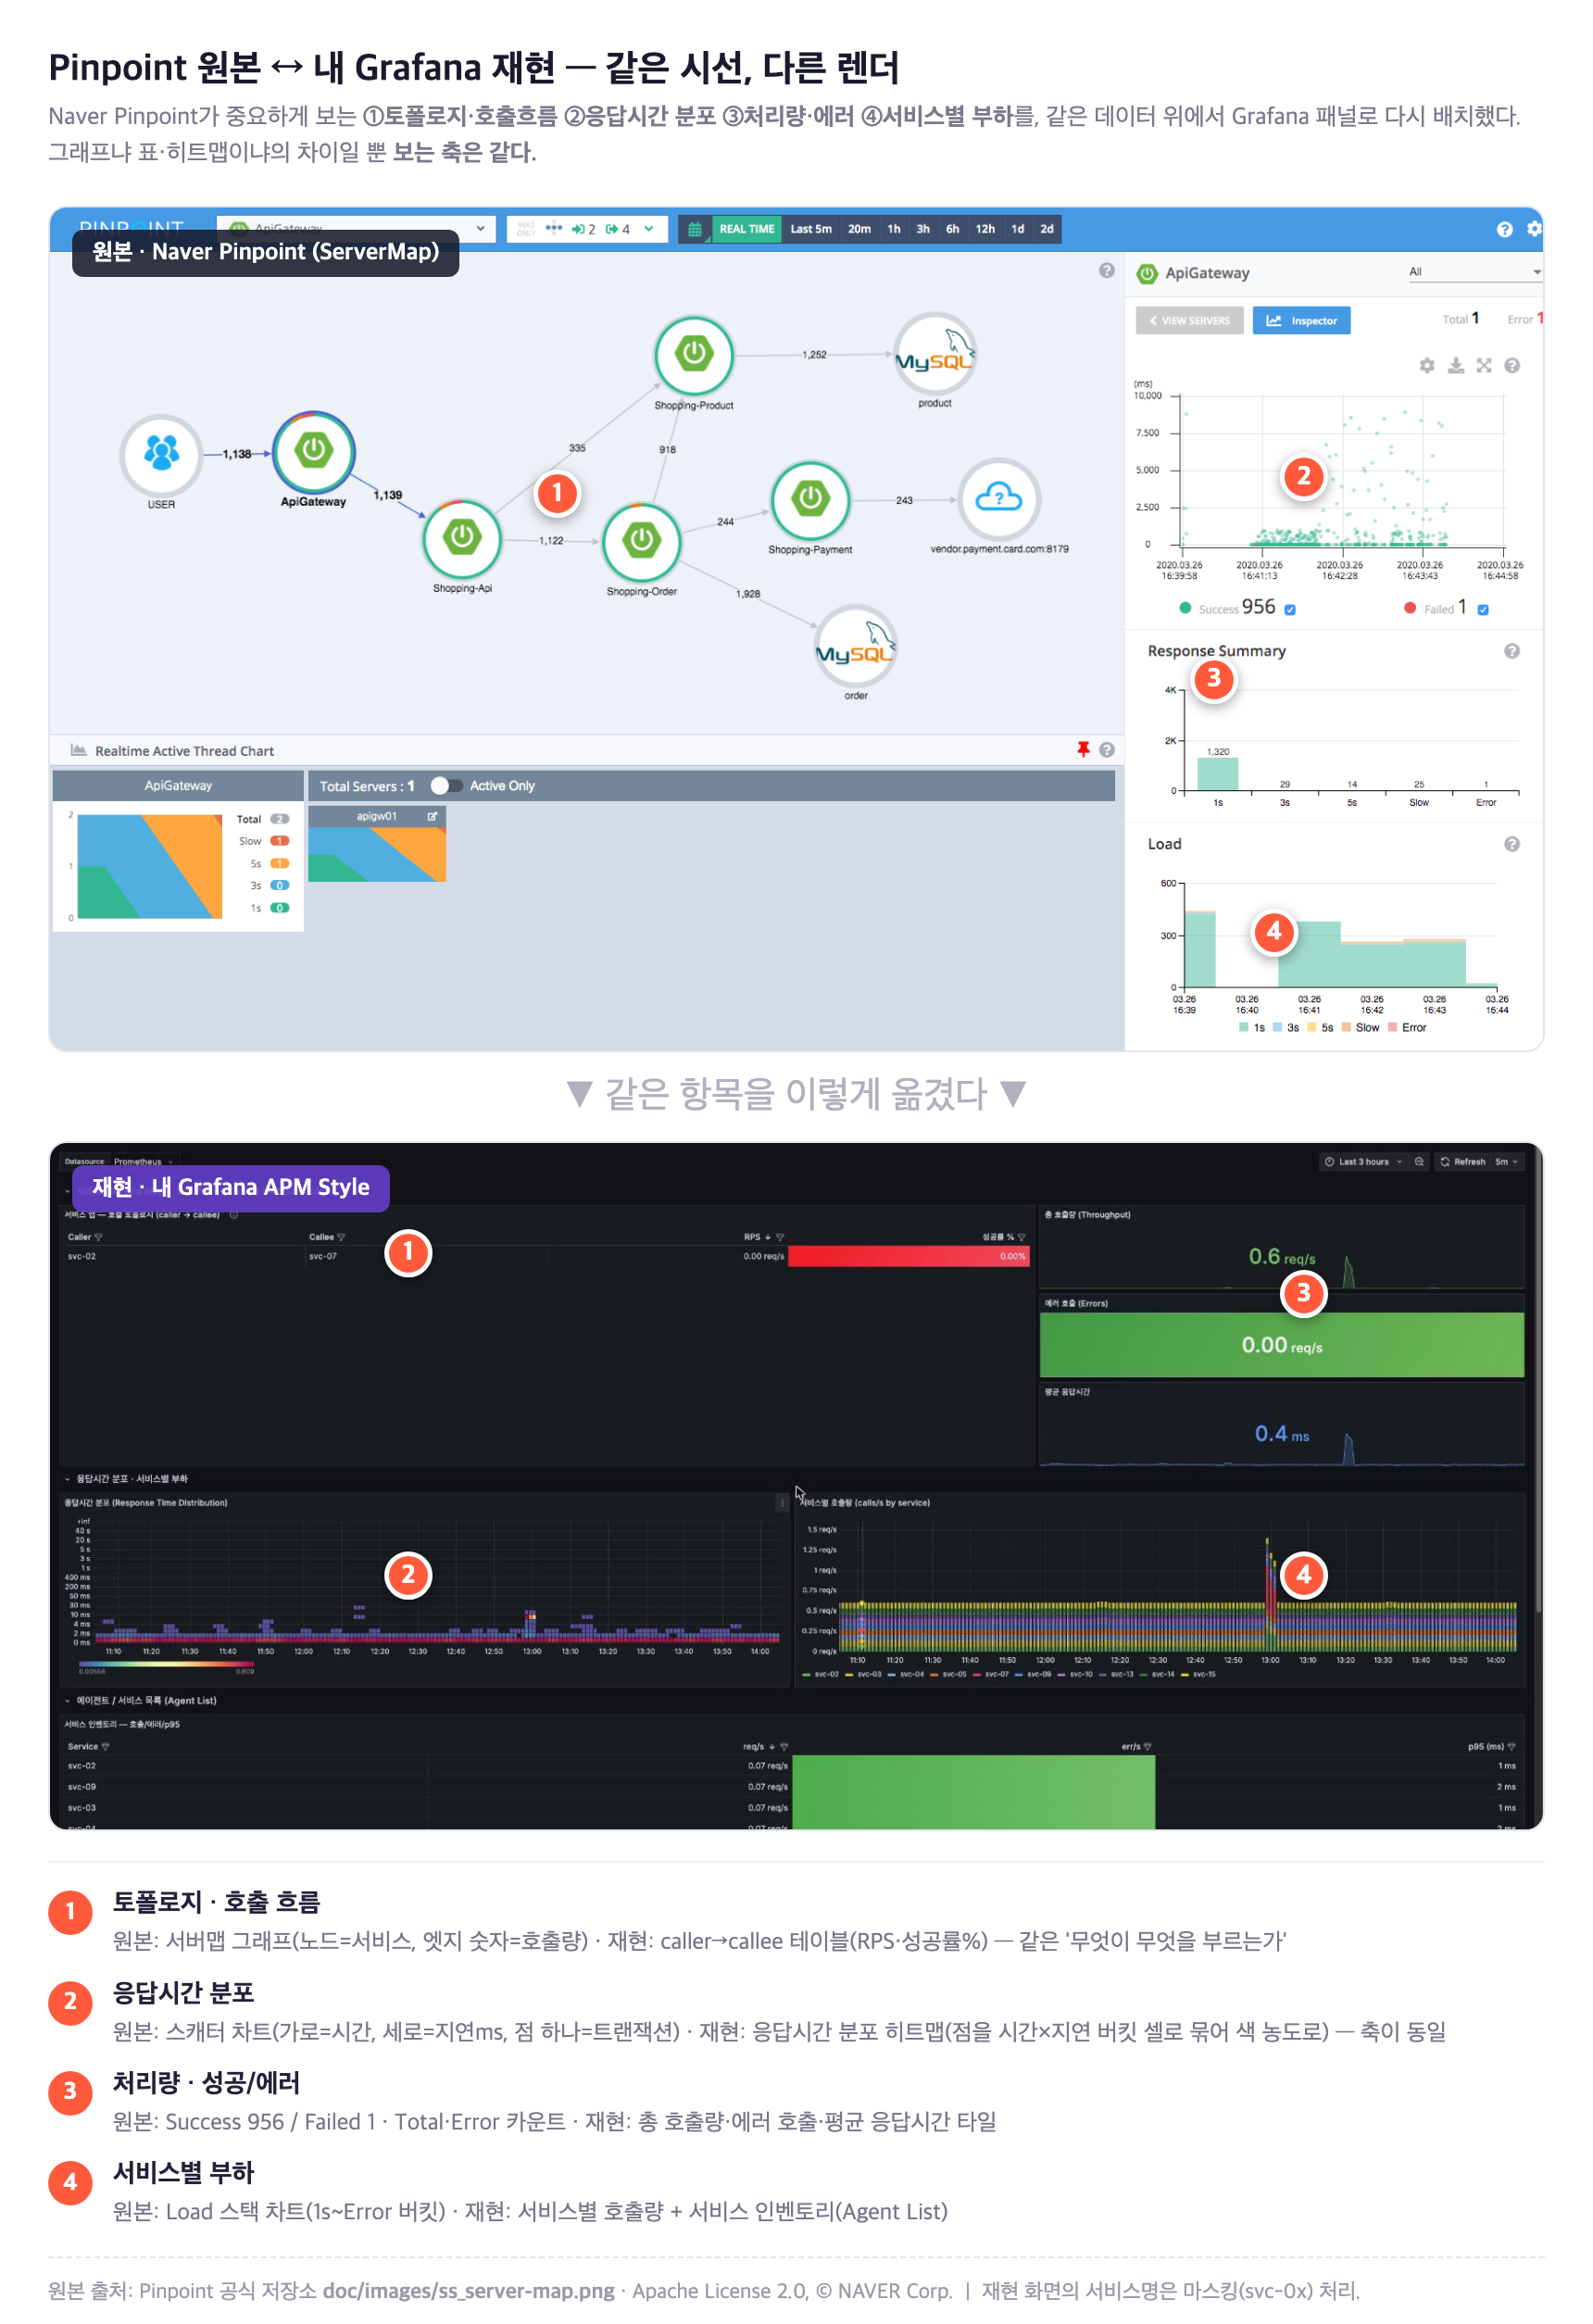
이미지 출처 — 원본(상단): Pinpoint 공식 저장소 github.com/pinpoint-apm/pinpoint (
doc/images/ss_server-map.png) · Apache License 2.0 · © NAVER Corp. | 재현(하단): 직접 구축한 Grafana 대시보드 · © 정성원 (서비스명 마스킹)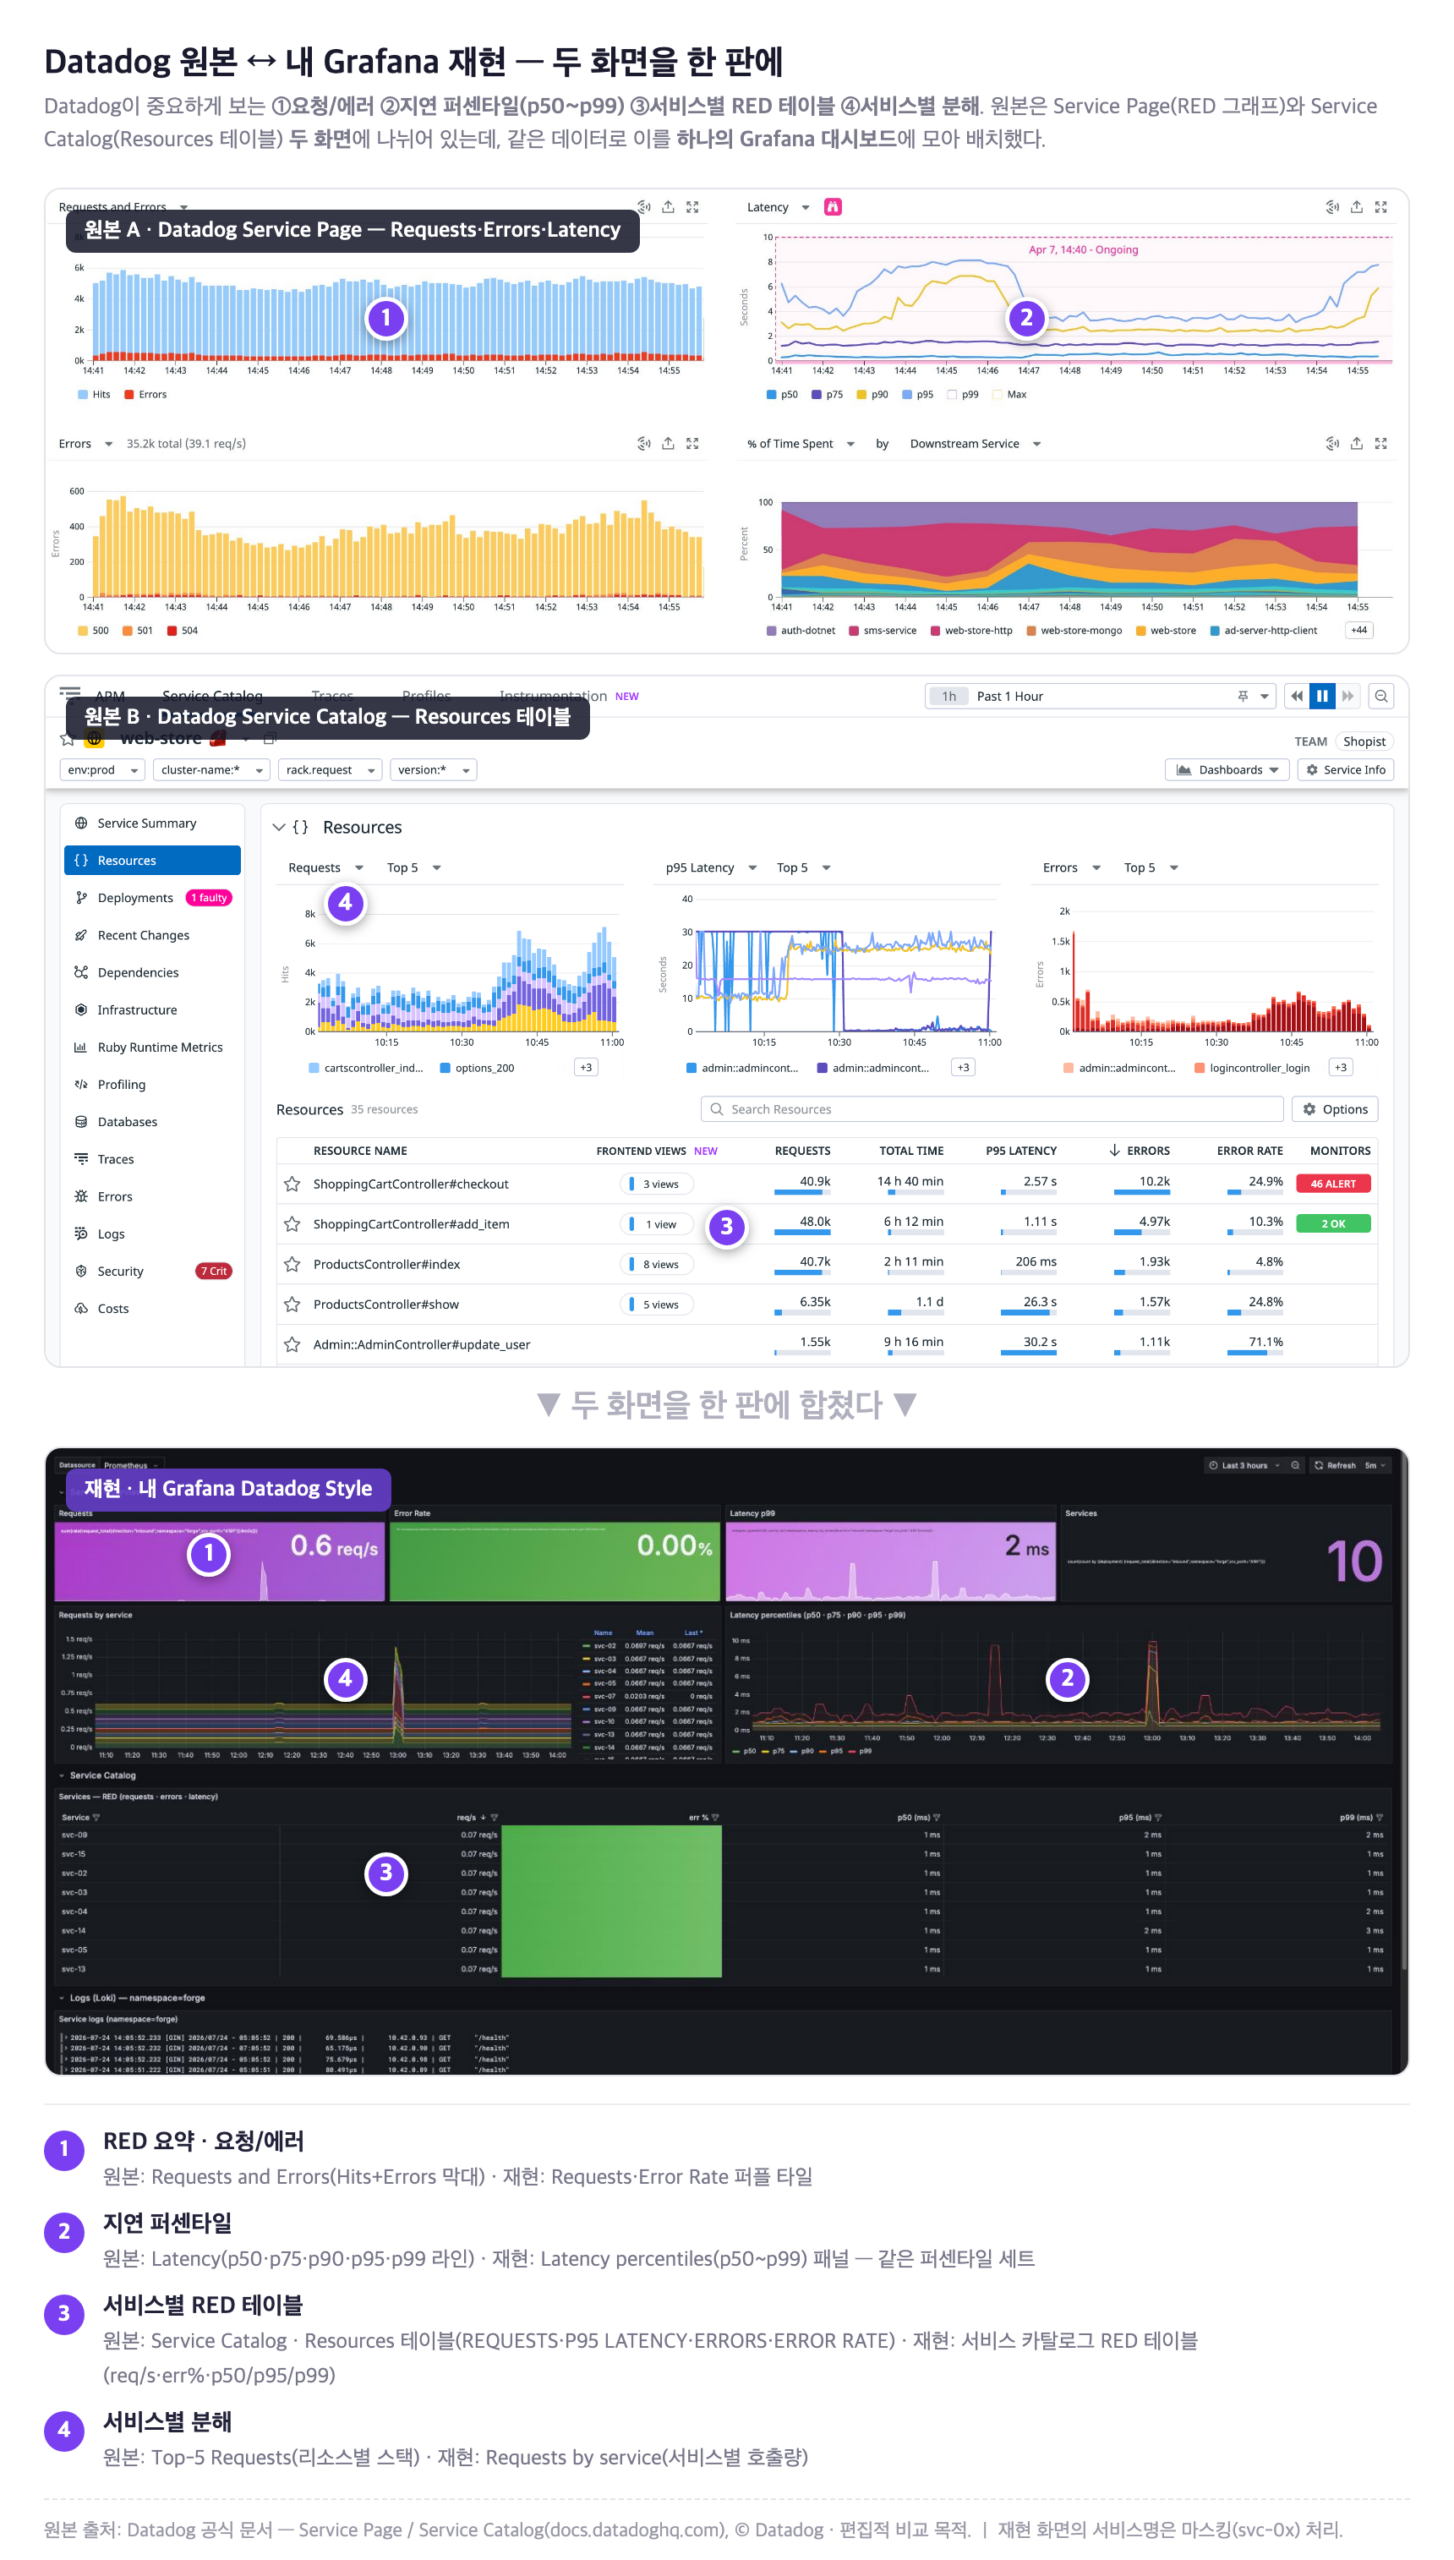
이미지 출처 — 원본(상단 2컷): Datadog 공식 문서 APM Service Page · © Datadog, Inc. (스타일 비교를 위한 인용) | 재현(하단): 직접 구축한 Grafana 대시보드 · © 정성원 (서비스명 마스킹)
화면을 닮게 둔 이유 — 빠른 적응을 위한 Style
다른 업종에서 Pinpoint나 Datadog으로 모니터링하시던 분이 내 홈랩에 앉았을 때, 이미 익숙한 배치라면 지표의 위치를 새로 외우지 않아도 된다. 서버맵을 보던 눈은 서버맵에서, RED 타일을 보던 눈은 RED 타일에서 곧바로 일을 시작할 수 있다. Style을 맞춰 두는 것만으로 적응 비용이 눈에 띄게 줄어든다고 봤다.
이런 스타일이 하나씩 쌓이며 내 ‘환경 구축 플러그인’은 점점 더 풍성해진다. 관측 스택을 세우는 삽질을 한 번 해두면 다음엔 스킬처럼 꺼내 쓸 수 있다. 그리고 실제로 그 화면을 써 본 분들의 피드백 — ‘여기선 이 지표가 위에 있어야 손이 간다’ 같은 — 을 받을수록 내 환경의 정밀도는 조금씩 더 높아질 거라 기대한다.
“No Data” 문제와 데모 생성기
트레이스 기반이라 계측된 앱이 없으면 화면이 빈다. 그래서 합성 텔레메트리 생성기(user→frontend→checkout→payment→postgres)를 옵션으로 붙여, 세 대시보드가 동시에 같은 데이터로 채워지게 했다.
3. 런타임 갭 — Compose 관측 스택이 k3s 파드를 못 봤다
여기까지는 순조로웠다. 그런데 화면을 채우고 있던 게 합성 데모 데이터뿐이라는 걸 뒤늦게 알아차렸다.
여기서 벽에 부딪혔다. 내 실제 서비스 15개는 k3s(쿠버네티스) 위에서 도는데, 관측 스택은 Docker Compose였다. Compose의 cadvisor·promtail은 k3s 파드를 못 본다. 즉 진짜 서비스가 하나도 관측되지 않고 있었다.

k8s-네이티브로 전환
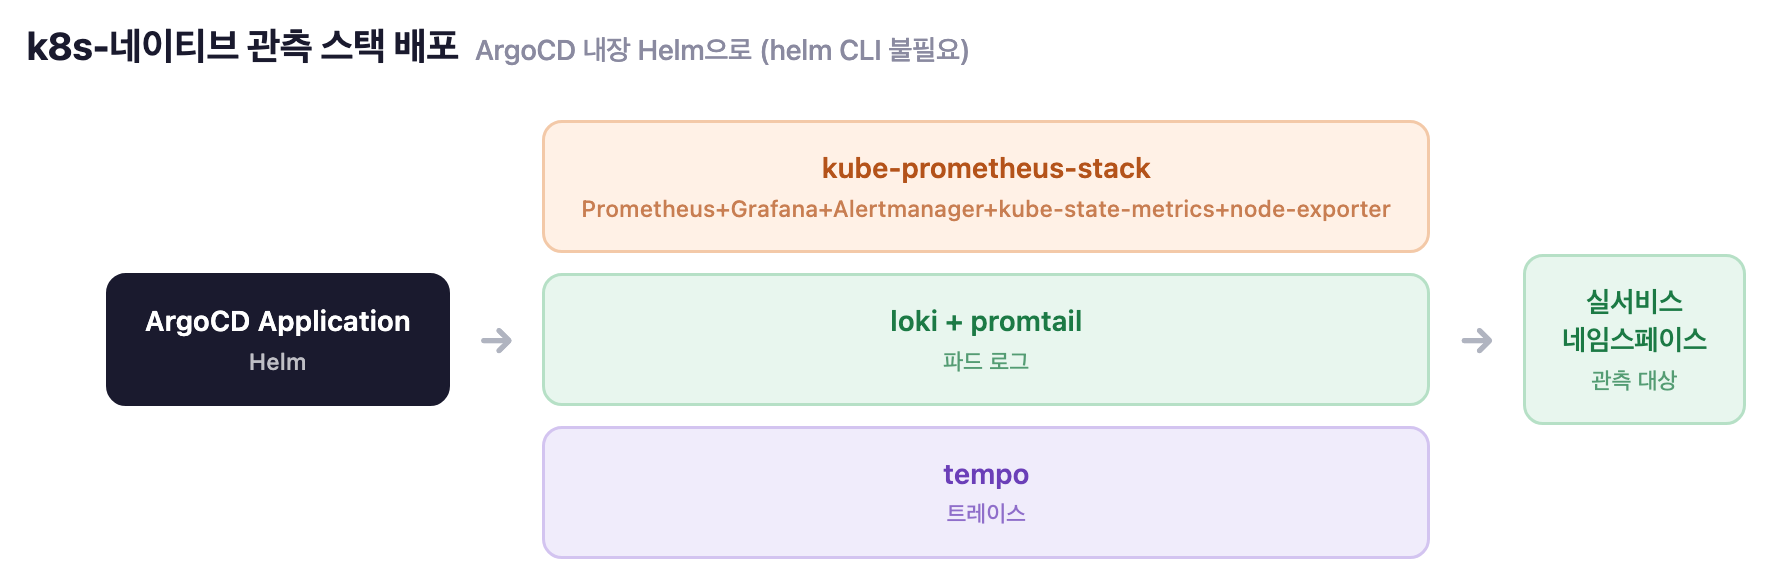
결정: kube-prometheus-stack + Loki + Tempo + Promtail 을 k3s에 올려, 실서비스 네임스페이스를 관측한다. 배포 엔진은 이미 깔아둔 ArgoCD의 내장 Helm(helm CLI 불필요). 이것도 스킬(SOT)로 코드화해서 --apply 한 번에 배포되게 했다.
즉시 얻은 것
앱 코드를 한 줄도 안 고치고 바로 얻은 관측:
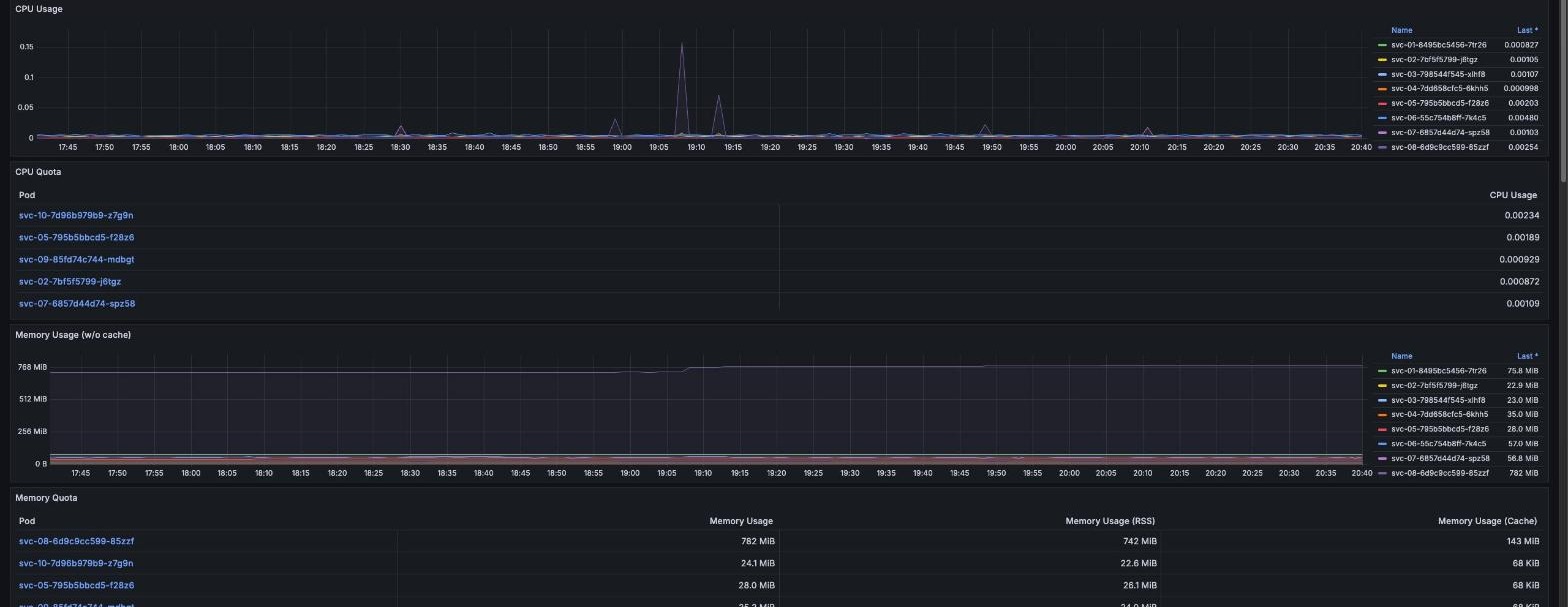
- 파드 메트릭: 15개 서비스의 CPU·메모리·재시작·상태 (kube-state-metrics + cadvisor)
- 로그: 모든 파드 로그가 Loki로 (promtail DaemonSet)
메트릭·로그는 코드 수정 없이 됐다. 문제는 서비스별 RED(요청률·에러·지연) — 이건 앱 계측이 필요하다. 여기서부터가 이 작업에서 가장 오래 걸린 대목이었다.
4. eBPF의 벽, 그리고 서비스메시로 RED 확보
실서비스가 관측되기 시작하자 마지막 빈칸이 드러났다. 그리고 이 단계에서 처음으로 계획이 통째로 어긋났는데, 그 실패도 그대로 적어 둔다.
실서비스의 RED(Rate·Errors·Duration) 를 코드 수정 없이 얻고 싶었다. 첫 시도는 Grafana Beyla — eBPF로 커널에서 HTTP를 자동 계측하는 도구. 이상적으로 들렸다.
Beyla 삽질기 (정직하게)
네 가지 정석 수정을 순서대로 적용했다.
discovery.instrument(v2+ 키 변경) — 옛 키가 무시되고 있었다- bpffs 마운트 —
/sys/fs/bpf가 파드에 없어 경고. 마운트하니 경고는 사라졌다 features: [application]— 네트워크 메트릭만 나오던 걸 앱 메트릭으로skip_go_specific_tracers— stripped Go 바이너리 대비 generic 트레이서 강제
결과: 그럼에도 실패. Beyla가 프로세스엔 붙는데 HTTP 스팬을 전혀 못 만들었다. 이 환경의 Go 바이너리에서 application 캡처가 작동하지 않았다. 게다가 Beyla 파드 자체가 OOMKilled·CrashLoopBackOff로 반복 재시작하며 불안정했다. 삽질은 kubectl로 정직하게 검증했고, 안 되는 건 안 된다고 기록했다.

kubectl로 확인)전환: Linkerd 서비스메시
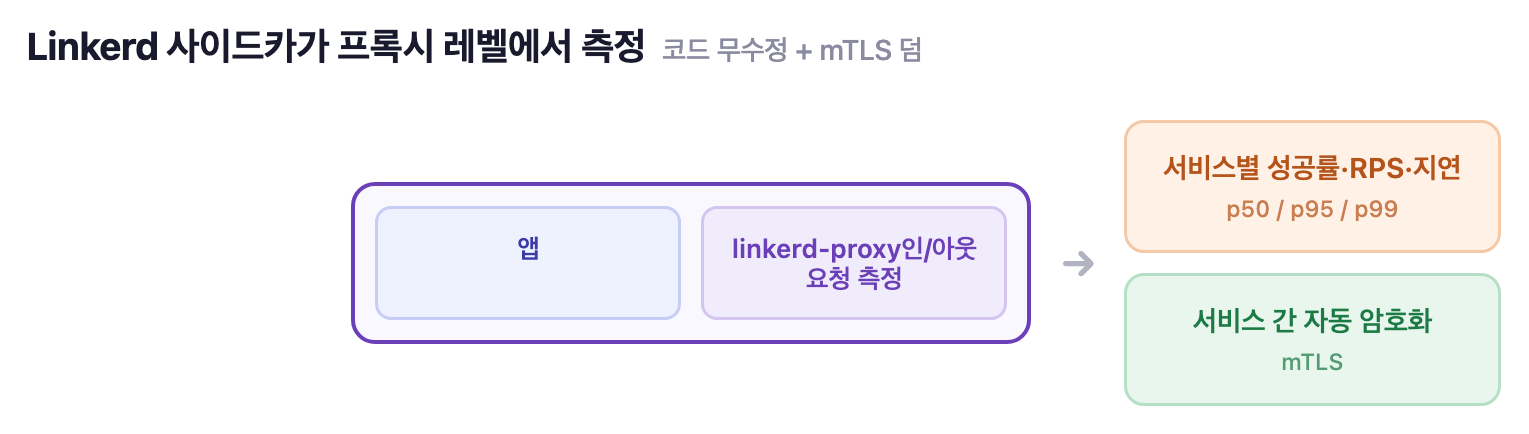
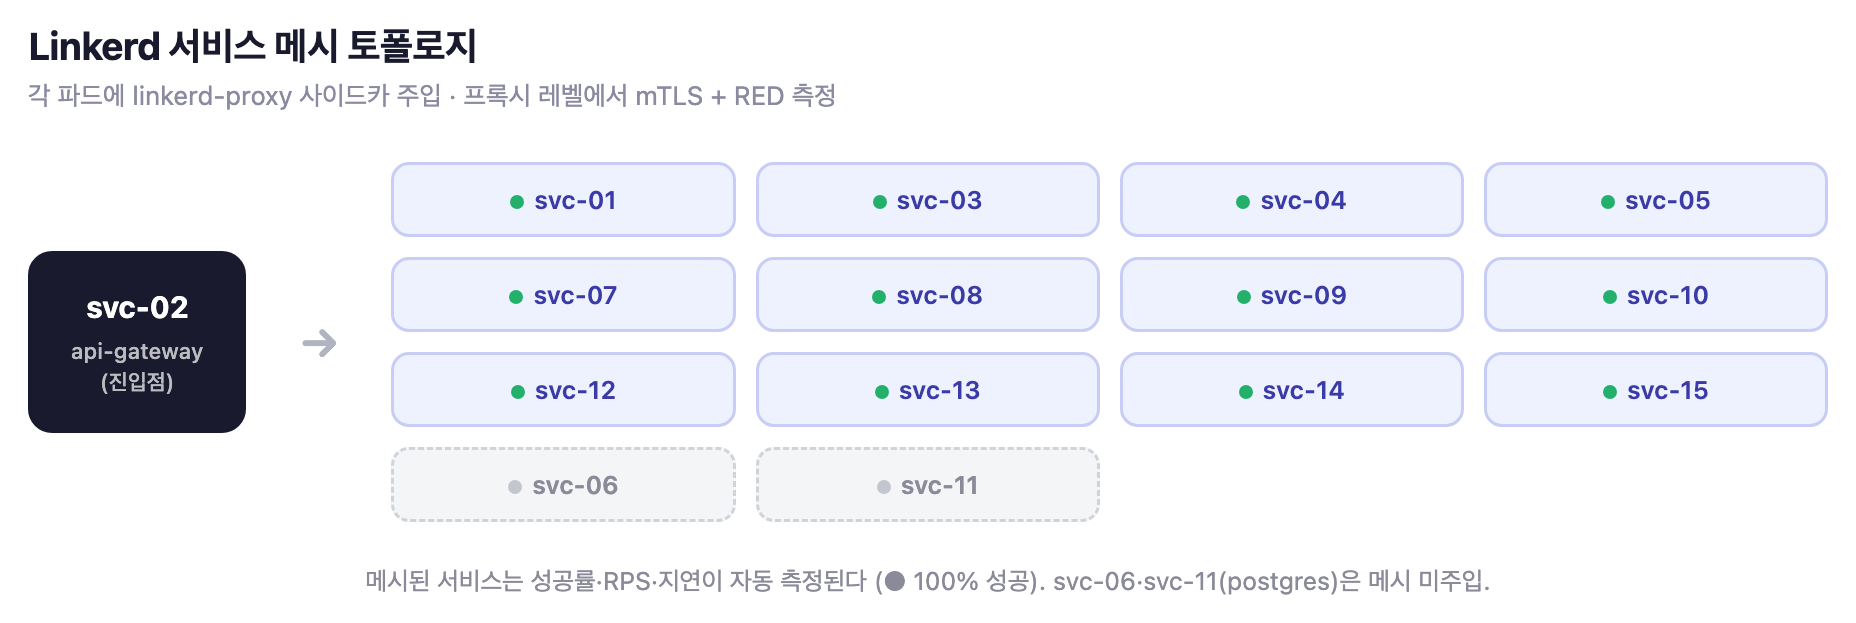
경로를 바꿨다. Linkerd 서비스메시는 각 파드에 프록시 사이드카를 주입해 프록시 레벨에서 모든 요청을 측정한다 — 코드 무수정 + mTLS 덤.
라이브 사이트라 카나리 1개만 먼저 주입해 RED가 나오는 걸 확인하고, 전체 13개를 주입했다(postgres는 제외). 주입 중 startup 레이스로 잠깐 CrashLoop이 났지만 자체 해소됐고, 공개 사이트는 유지됐다.

메인 Grafana에 통합
마지막으로 Linkerd 프록시 메트릭(:4191)을 kube-prometheus-stack이 스크랩하도록 ScrapeConfig를 붙이고, 전용 “서비스 RED” 대시보드를 프로비저닝했다. 이제 하나의 Grafana에 메트릭 + 로그 + RED가 모였다.
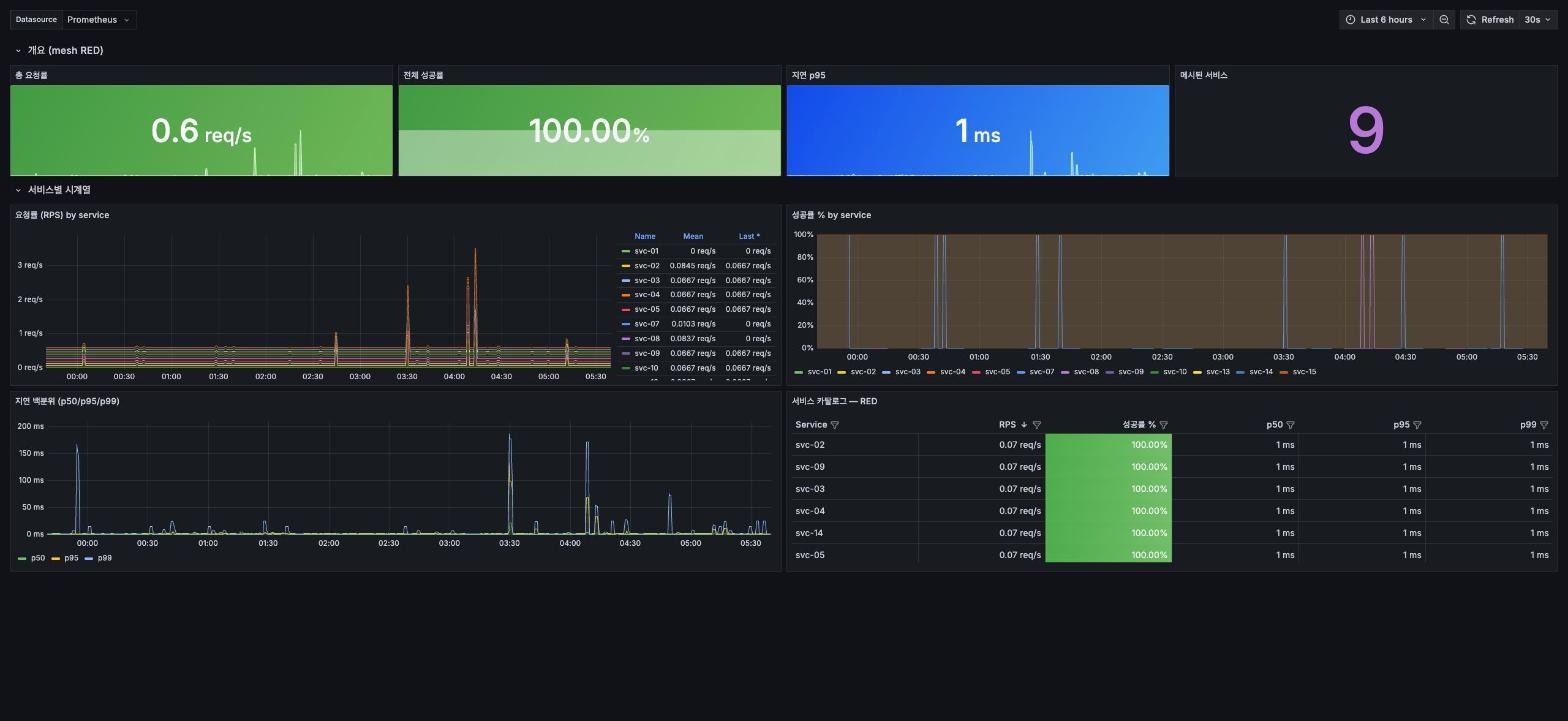
교훈: eBPF 자동계측은 마법 같지만 환경/바이너리를 탄다. 안 될 때 억지로 매달리기보다, 프록시 메시라는 확실한 대안으로 우회하는 게 빨랐다.
5. 보안 — 관측 도메인을 ‘내 IP·내 노트북만’ 허용하기
화면이 갖춰지자 성격이 다른 문제가 남았다. 이것들을 도메인에 붙여 두었다는 것.
Grafana·ArgoCD·Linkerd 대시보드를 Cloudflare Tunnel로 도메인에 연결했다. 그런데 문제가 있다. 특히 Linkerd viz 대시보드는 자체 로그인이 아예 없다. 도메인만 알면 누구나 들어온다.
Cloudflare Access — 도메인 앞단 인증 게이트
해법은 Cloudflare Zero Trust Access. 요청이 앱에 도달하기 전에 Cloudflare 엣지에서 정책을 검사한다. 목표는 “내 IP 또는 내 노트북만”.
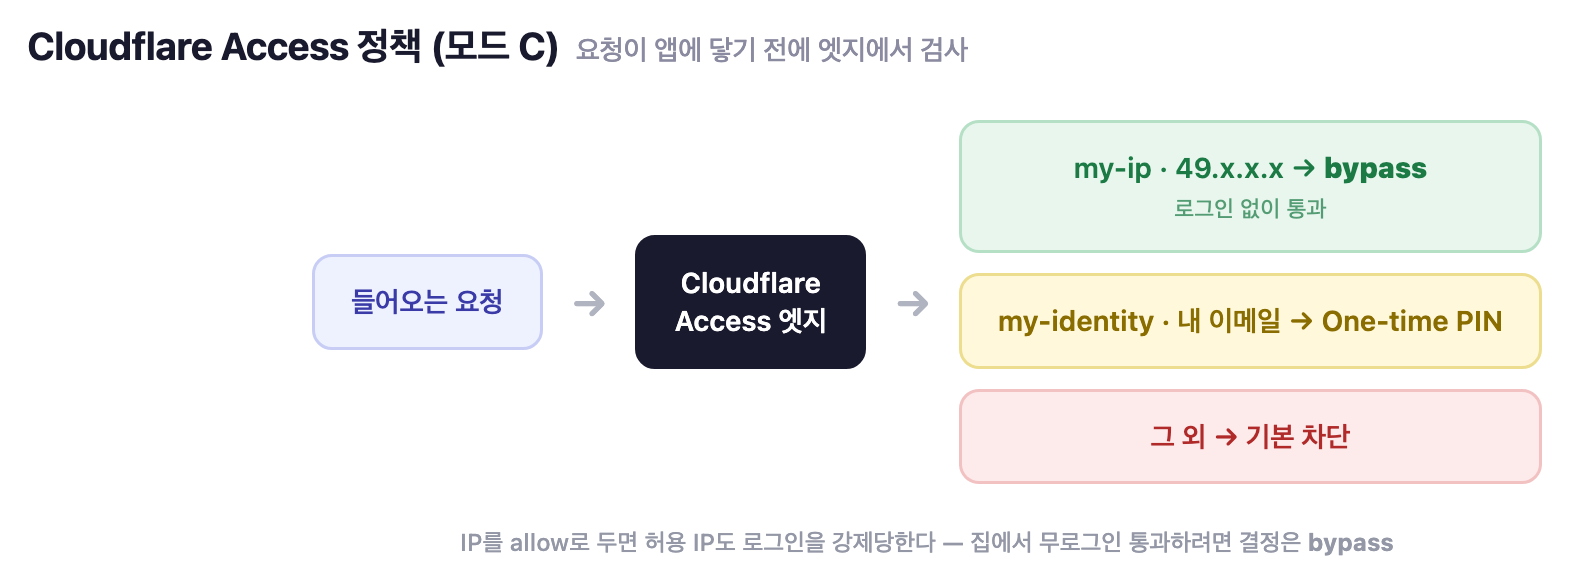
여기서 하나 배웠다. IP 정책을 allow로 하면 허용 IP도 로그인을 강제당한다. 집에서 로그인 없이 통과하려면 bypass 결정이어야 한다.
대시보드 클릭 대신 API로
개입을 최소화하려고 Cloudflare API v4로 Access 앱+정책을 코드화하는 스킬(cf-access)을 만들었다. 토큰만 있으면 세 도메인을 명령 한 번에 게이팅한다. 멱등(도메인/정책명 기준).
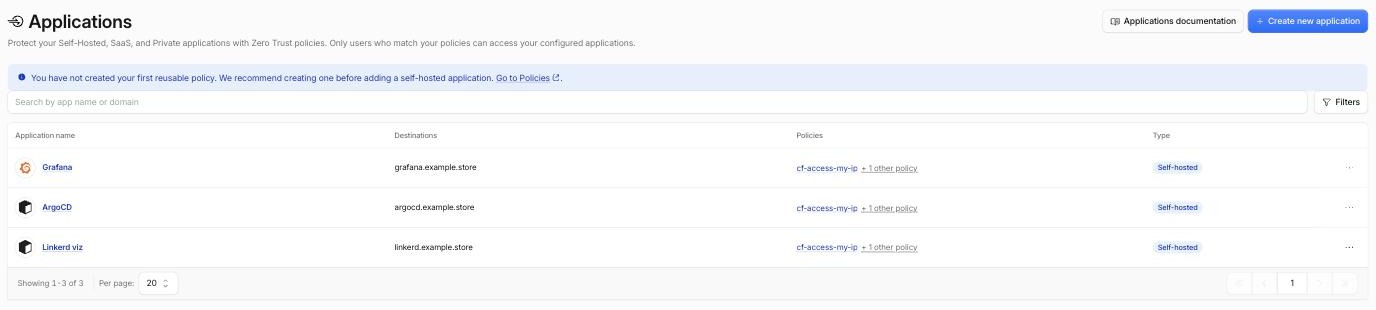
cf-access-my-ip 정책으로 게이팅(Self-hosted). 이메일·도메인은 마스킹
검증: 내 IP(서버)에서는 로그인 없이 앱에 바로 도달(302→/login은 Grafana 자체), 다른 IP는 Cloudflare OTP 화면으로 리다이렉트. IP가 바뀌면 --set-ip 한 줄로 갱신.
Cloudflare Tunnel이 “호스트네임→localhost 라우팅”이라면, Access는 “누가 접근 가능한지”를 책임진다. 레이어가 다르다.
6. GitOps — 라이브 서비스를 깨지 않고 ArgoCD로
마지막은 배포 쪽이다.
마지막 조각. kubectl apply로 배포해온 실서비스 15개를 ArgoCD GitOps 관리로 옮긴다. 목표는 배포 가시성·드리프트 감지·롤백. 단, 라이브 프로덕션이라 절대 깨면 안 된다.
가장 큰 리스크
이 서비스들은 방금 Linkerd 주입된 상태다. 매니페스트엔 그 annotation이 없다. ArgoCD auto-sync를 잘못 켜면 주입을 되돌려 메시를 벗겨버린다 → RED/mTLS 붕괴.
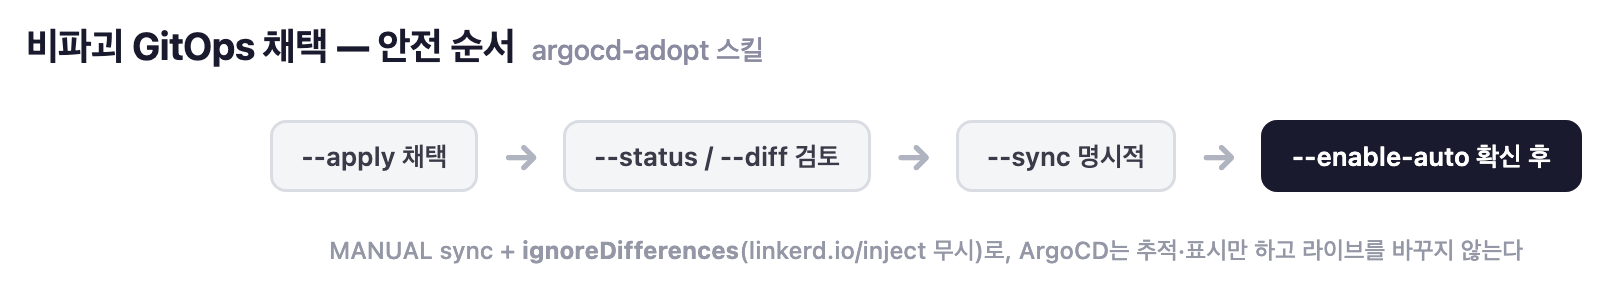
비파괴 채택 (argocd-adopt 스킬)
안전장치를 스킬에 박았다.
- MANUAL sync: 자동화 없음 → ArgoCD가 추적·표시만, 아무 것도 안 바꿈
- ignoreDifferences:
linkerd.io/injectannotation 무시 → 메시 안 벗겨짐 - 비-매니페스트(
*.conf) exclude,CreateNamespace=false
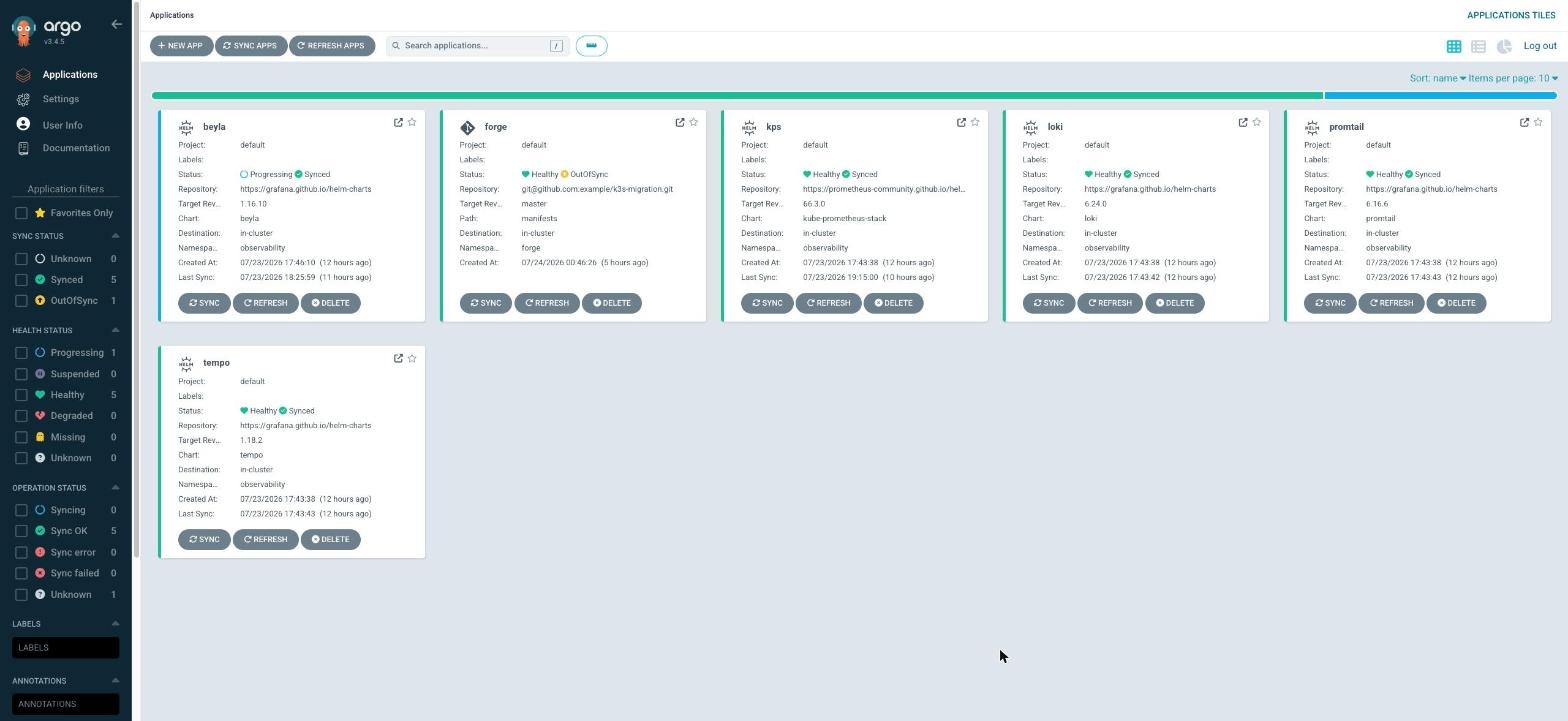
“OutOfSync”가 무섭지 않은 이유
채택 직후 상태는 OutOfSync. 하지만 kubectl diff로 git 매니페스트 적용 시 실제 변경을 확인하니 변경 0개였다. OutOfSync의 정체는 last-applied-configuration annotation 정리(메타데이터)뿐 — 파드·spec 무변경. 게이트웨이 NodePort도 git에 있어 공개 사이트 안전.
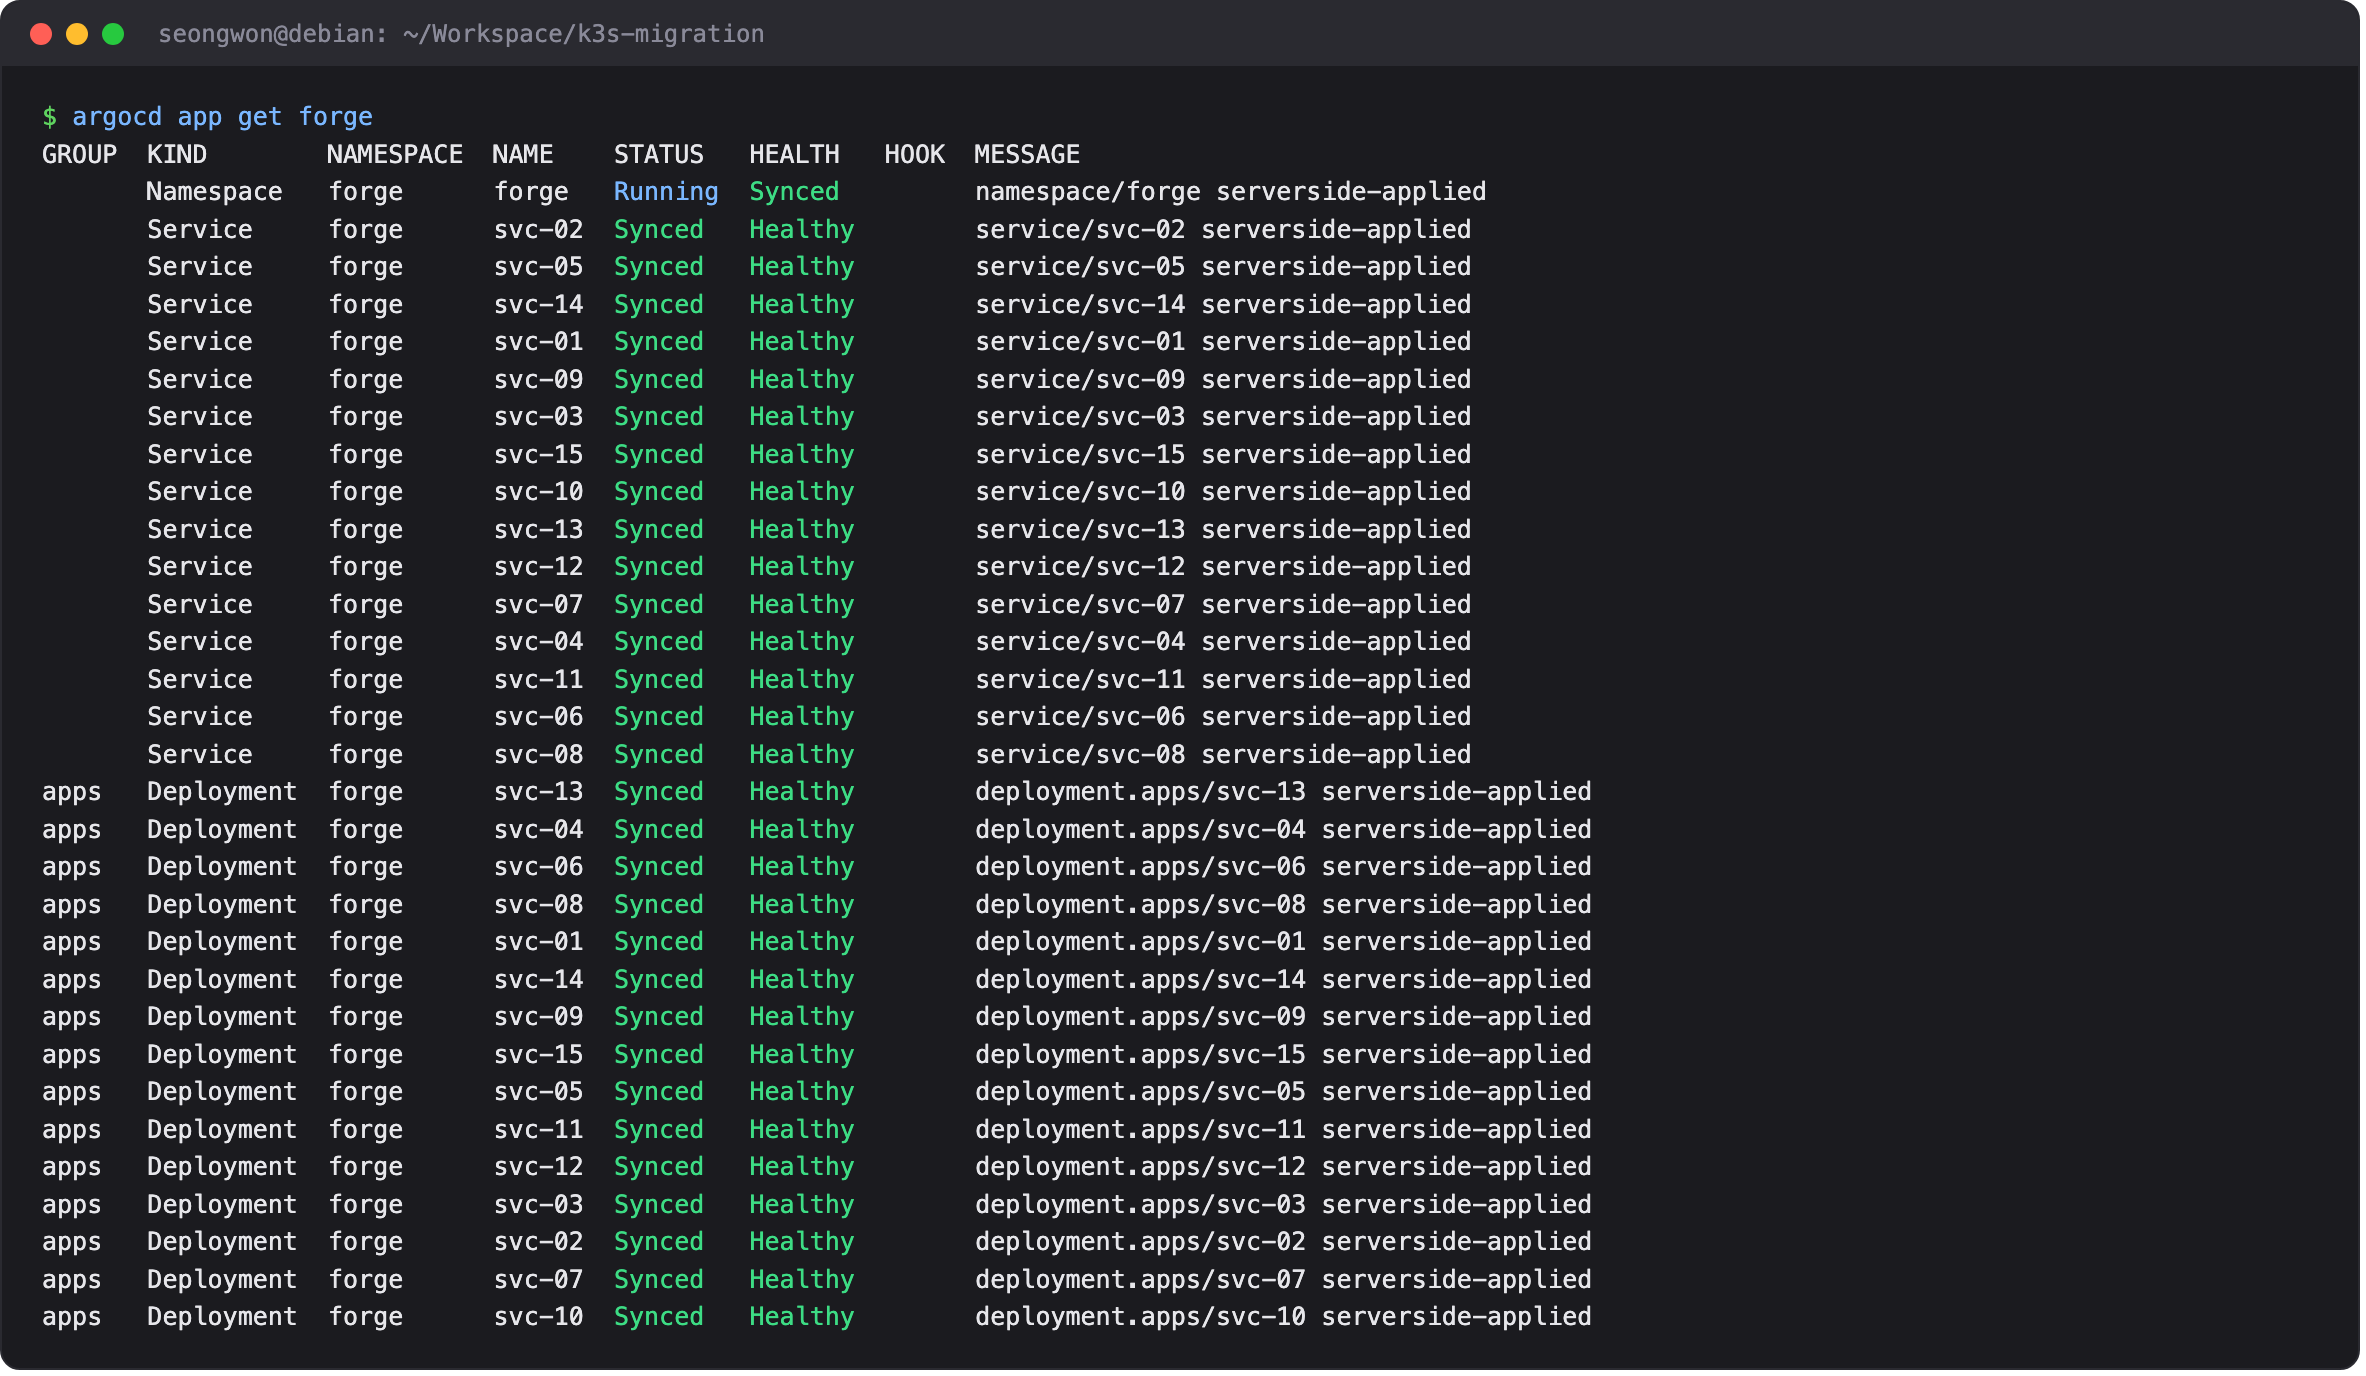
argocd app get forge — Service·Deployment 전 리소스가 Synced·Healthy(serverside-applied). 드리프트 0 (서비스명은 svc-*로 익명화)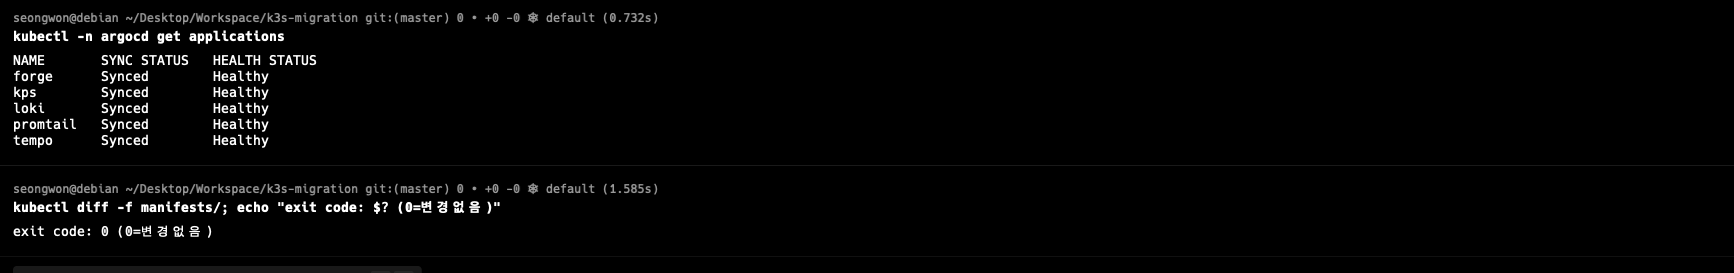
kubectl diff -f manifests/ — git 매니페스트 적용 시 실제 변경 0개(exit 0). OutOfSync의 정체는 last-applied-configuration 메타데이터 정리뿐, 파드·spec 무변경.정석 GitOps posture
결론적으로 forge는 ArgoCD가 모니터링(드리프트 감지·가시성·롤백)하되, 라이브를 함부로 바꾸지 않는 manual 상태로 뒀다. 프로덕션에서 흔히 택하는 안전한 GitOps 자세다. 다음에 배포를 바꿀 땐 git에 커밋하고 명시적으로 sync하면 된다.

kubectl -n argocd get applications — forge 포함 관측 스택 앱까지 전부 Synced·Healthy시리즈를 마치며 — 홈서버 하나에 관측성(메트릭·로그·트레이스·RED) → 보안 게이팅 → GitOps까지, 전부 “하나의 규칙으로 굴러가는 스킬(SOT)”로 코드화했다. 손맛이 아니라 재현 가능한 자동화로. 각 편의 스킬은 그대로 다른 프로젝트에도 재사용된다.
여섯 단계를 지나고 남은 것
| 단계 | 선택 | 결과 |
|---|---|---|
| 스택 구축 | 짧은 보존창 + /home bind-mount | 메모리 ~1.4%, CPU ~2%로 안착 |
| 대시보드 | Tempo metrics-generator 한 소스 | 세 가지 시선을 같은 데이터로 |
| 런타임 갭 | Compose → k8s-네이티브 | 실서비스 15개가 코드 무수정으로 관측 |
| RED | eBPF 포기 → Linkerd | 서비스별 성공률·p95 확보 + mTLS |
| 보안 | Cloudflare Access(bypass 정책) | 로그인 없는 대시보드에 앞단 게이트 |
| GitOps | MANUAL sync + ignoreDifferences | 드리프트 감지만, 라이브 무변경 |
가장 크게 배운 건 4단계였다. 정석 수정 네 가지를 순서대로 적용하고도 안 된다는 걸 확정하는 데 시간을 꽤 썼는데, 돌이켜보면 “안 되는 걸 안 된다고 못 박은” 그 시간이 낭비는 아니었다. 다만 다음엔 대안 경로를 병렬로 시험했을 것 같다. 한 갈래에 매달리는 동안 다른 갈래는 아무것도 진행되지 않는다.
그리고 전체를 관통하는 규칙이 하나 있었다. 각 단계를 손으로 하지 않고 스킬(SOT, Source of Truth)로 코드화했다는 점이다. 스택 기동도, Cloudflare Access 정책도, ArgoCD 채택도 명령 한 번으로 재현된다. 손맛이 아니라 재현 가능한 자동화로 남겨 두면, 다음 프로젝트에서 같은 삽질을 반복하지 않는다.
이어서 읽기
이 스택을 올려 둔 뒤로는 ‘초록불인데 고장나 있는’ 경우를 자주 만났다. 그때마다 계층을 하나씩 배제해 원인을 좁힌 기록을 아래에 둔다.
답글 남기기