
부제: 명령형("이 컨테이너를 켜라")이 아니라 선언형("이 상태로 유지해둬라")
지난 편(A1)에서
컨테이너의 정체를 "커널이 namespace로 격리하고 cgroup으로 제한한 그냥
프로세스"로 정리했다. 그러면 다음 질문이 자연스럽다.
컨테이너 하나는 이렇게 이해했는데, 이게 수십·수백 개로 늘어나 여러 머신에
흩어지면 누가 관리하는가?
수작업으로는 감당이 안 된다. 어느 서버에 몇 개를 띄울지 정하고, 죽으면 다시
살리고, 버전을 바꿔 끼우고… 이 반복을 대신 맡아 주는 관리자가
쿠버네티스다. 이번 편은 그 관리 구조를 개념마다 한 줄씩 못박고 간다.
쿠버네티스(Kubernetes) 한 줄 정의 — 여러 대의 머신에 흩어진 컨테이너
무리를, "이 상태로 유지하라"는 선언만으로 배치·복구·확장·교체를 대신 맡아
관리하는 오케스트레이터(관리자). 컨테이너 하나를 다루는 게 도커라면,
컨테이너 무리를 다루는 게 쿠버네티스다.
(A1에서 도커·컨테이너
쪽을 먼저 굳혔다.)
한 줄 정의부터
| 용어 | 한 줄 정의 |
|---|---|
| Control Plane | 원하는 상태를 받아 실제 상태로 맞추는 관리자(두뇌) |
| Node | 실제로 Pod를 돌리는 일꾼 머신(kubelet + 런타임) |
| Pod | 쿠버네티스가 다루는 최소 배포 단위(컨테이너 1개 이상 묶음) |
| Namespace(k8s) | 클러스터를 논리적으로 나누는 폴더(물리 자원 X, 이름표 공간 O) |
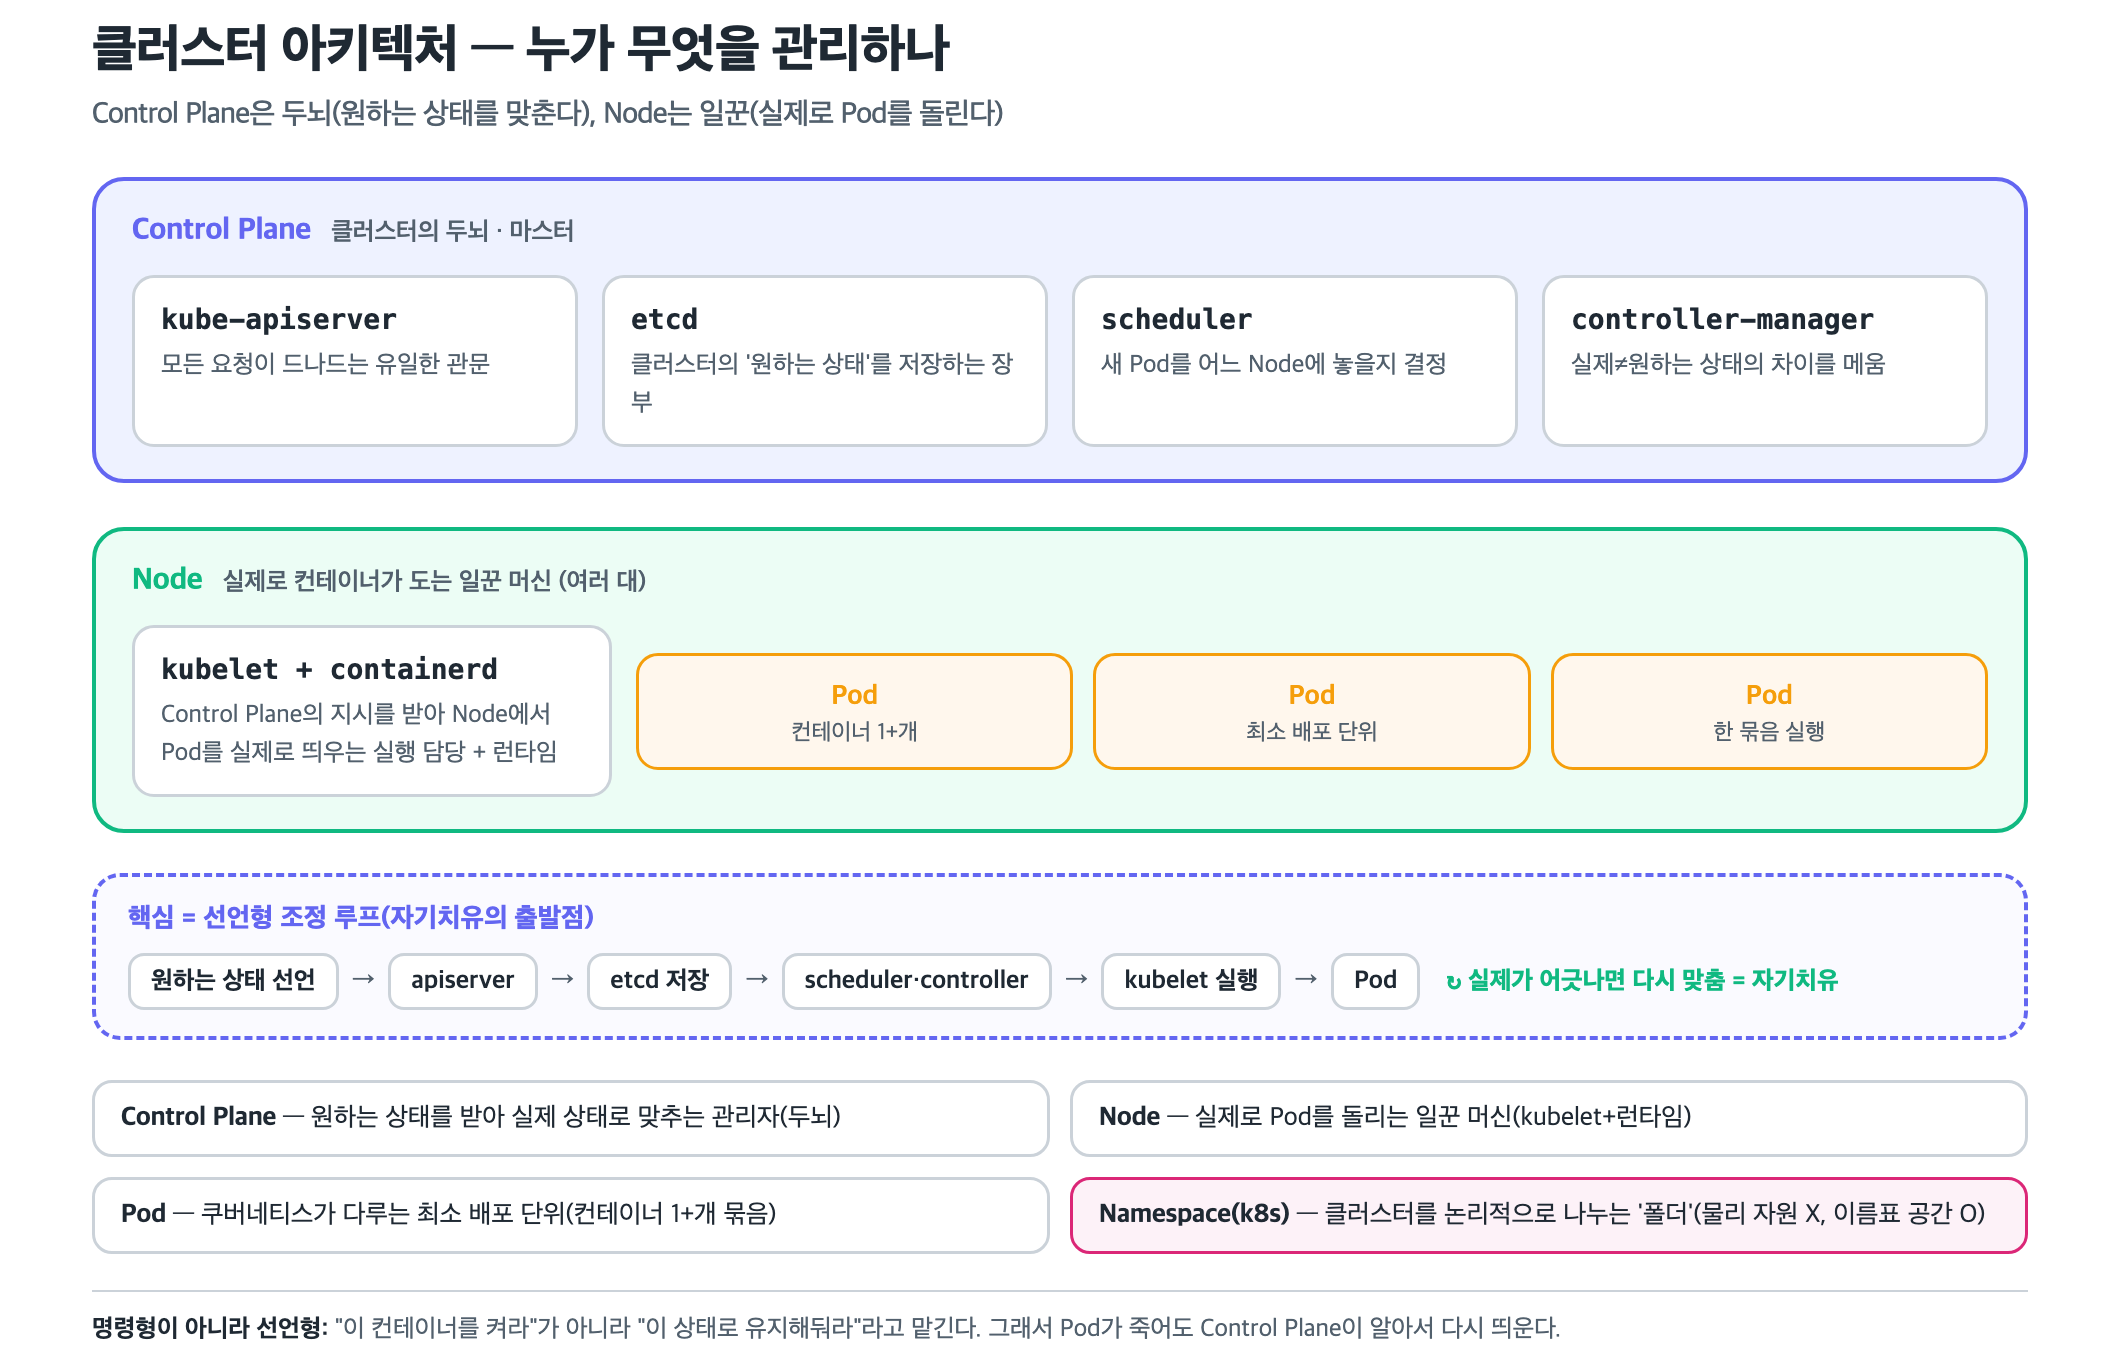
Control Plane — 클러스터의 두뇌
Control Plane은 한 덩어리가 아니라 역할이 다른 컴포넌트 몇 개의 묶음이다.
- kube-apiserver — 모든 요청이 드나드는 유일한 관문.
kubectl도,
다른 컴포넌트도 전부 여기를 거친다. 클러스터의 정문이자 교환대. - etcd — 클러스터의 "원하는 상태"를 저장하는 장부. "웹 서버 3개를
유지" 같은 선언이 여기 적힌다. etcd가 클러스터의 단일 진실 원본(SSOT). - kube-scheduler — 새 Pod를 어느 Node에 놓을지 결정한다. 자원 여유·제약
조건을 보고 자리를 배정. - kube-controller-manager — 실제 상태와 원하는 상태의 차이를 메운다.
"3개여야 하는데 2개뿐"이면 1개를 더 띄우도록 움직인다.
Node — 실제로 Pod를 돌리는 일꾼
Control Plane이 "결정"이라면 Node는 "실행"이다. 각 Node에는:
- kubelet — Control Plane의 지시를 받아 이 Node에서 Pod를 실제로 띄우고
상태를 보고하는 실행 담당. - 컨테이너 런타임 — 실제로 컨테이너를 굴리는 엔진. 요즘은 containerd가
기본이다(도커가 아니다 — A1에서 "도커 없이도 컨테이너는 존재한다"고 한 그
대목의 실제 증거).
Pod — 왜 컨테이너가 아니라 ‘Pod’인가
쿠버네티스는 컨테이너를 직접 다루지 않고 Pod라는 한 겹을 더 씌운다.
Pod는 하나 이상의 컨테이너를 한 묶음으로 실행하는 최소 배포 단위다.
같은 Pod 안의 컨테이너들은 네트워크(같은 IP)와 저장소를 공유한다.
"메인 앱 + 로그 수집 사이드카"처럼 떼어놓을 수 없는 짝을 한 단위로 다루려는
장치다. 그래서 쿠버네티스의 배포·스케일·복구는 전부 Pod 단위로 움직인다.
핵심 — 선언형 조정 루프(자기치유)
쿠버네티스를 관통하는 한 문장은 이것이다. 명령형이 아니라 선언형.
- 명령형: "3번 서버에 컨테이너를 켜라" (내가 매번 지시)
- 선언형: "웹 서버는 항상 3개 유지" (원하는 상태만 맡긴다)
원하는 상태를 apiserver로 선언하면 → etcd에 적히고 → scheduler·controller가
현재와 비교해 → kubelet이 실제로 맞춘다. 그리고 이 루프는 끊임없이 돈다.
Pod가 하나 죽어 "3 ≠ 2"가 되면 controller가 즉시 1개를 더 띄운다. 내가
아무것도 안 해도 상태가 스스로 복구된다 — 이게 자기치유(self-healing),
그리고 쿠버네티스를 쓰는 가장 큰 이유다.
Namespace — "그냥 폴더가 하나 생겼다"
여기서부터는 말보다 콘솔이 빠르다. 지금 이 글을 쓰며 로컬 클러스터에서 그대로
캡처했다.
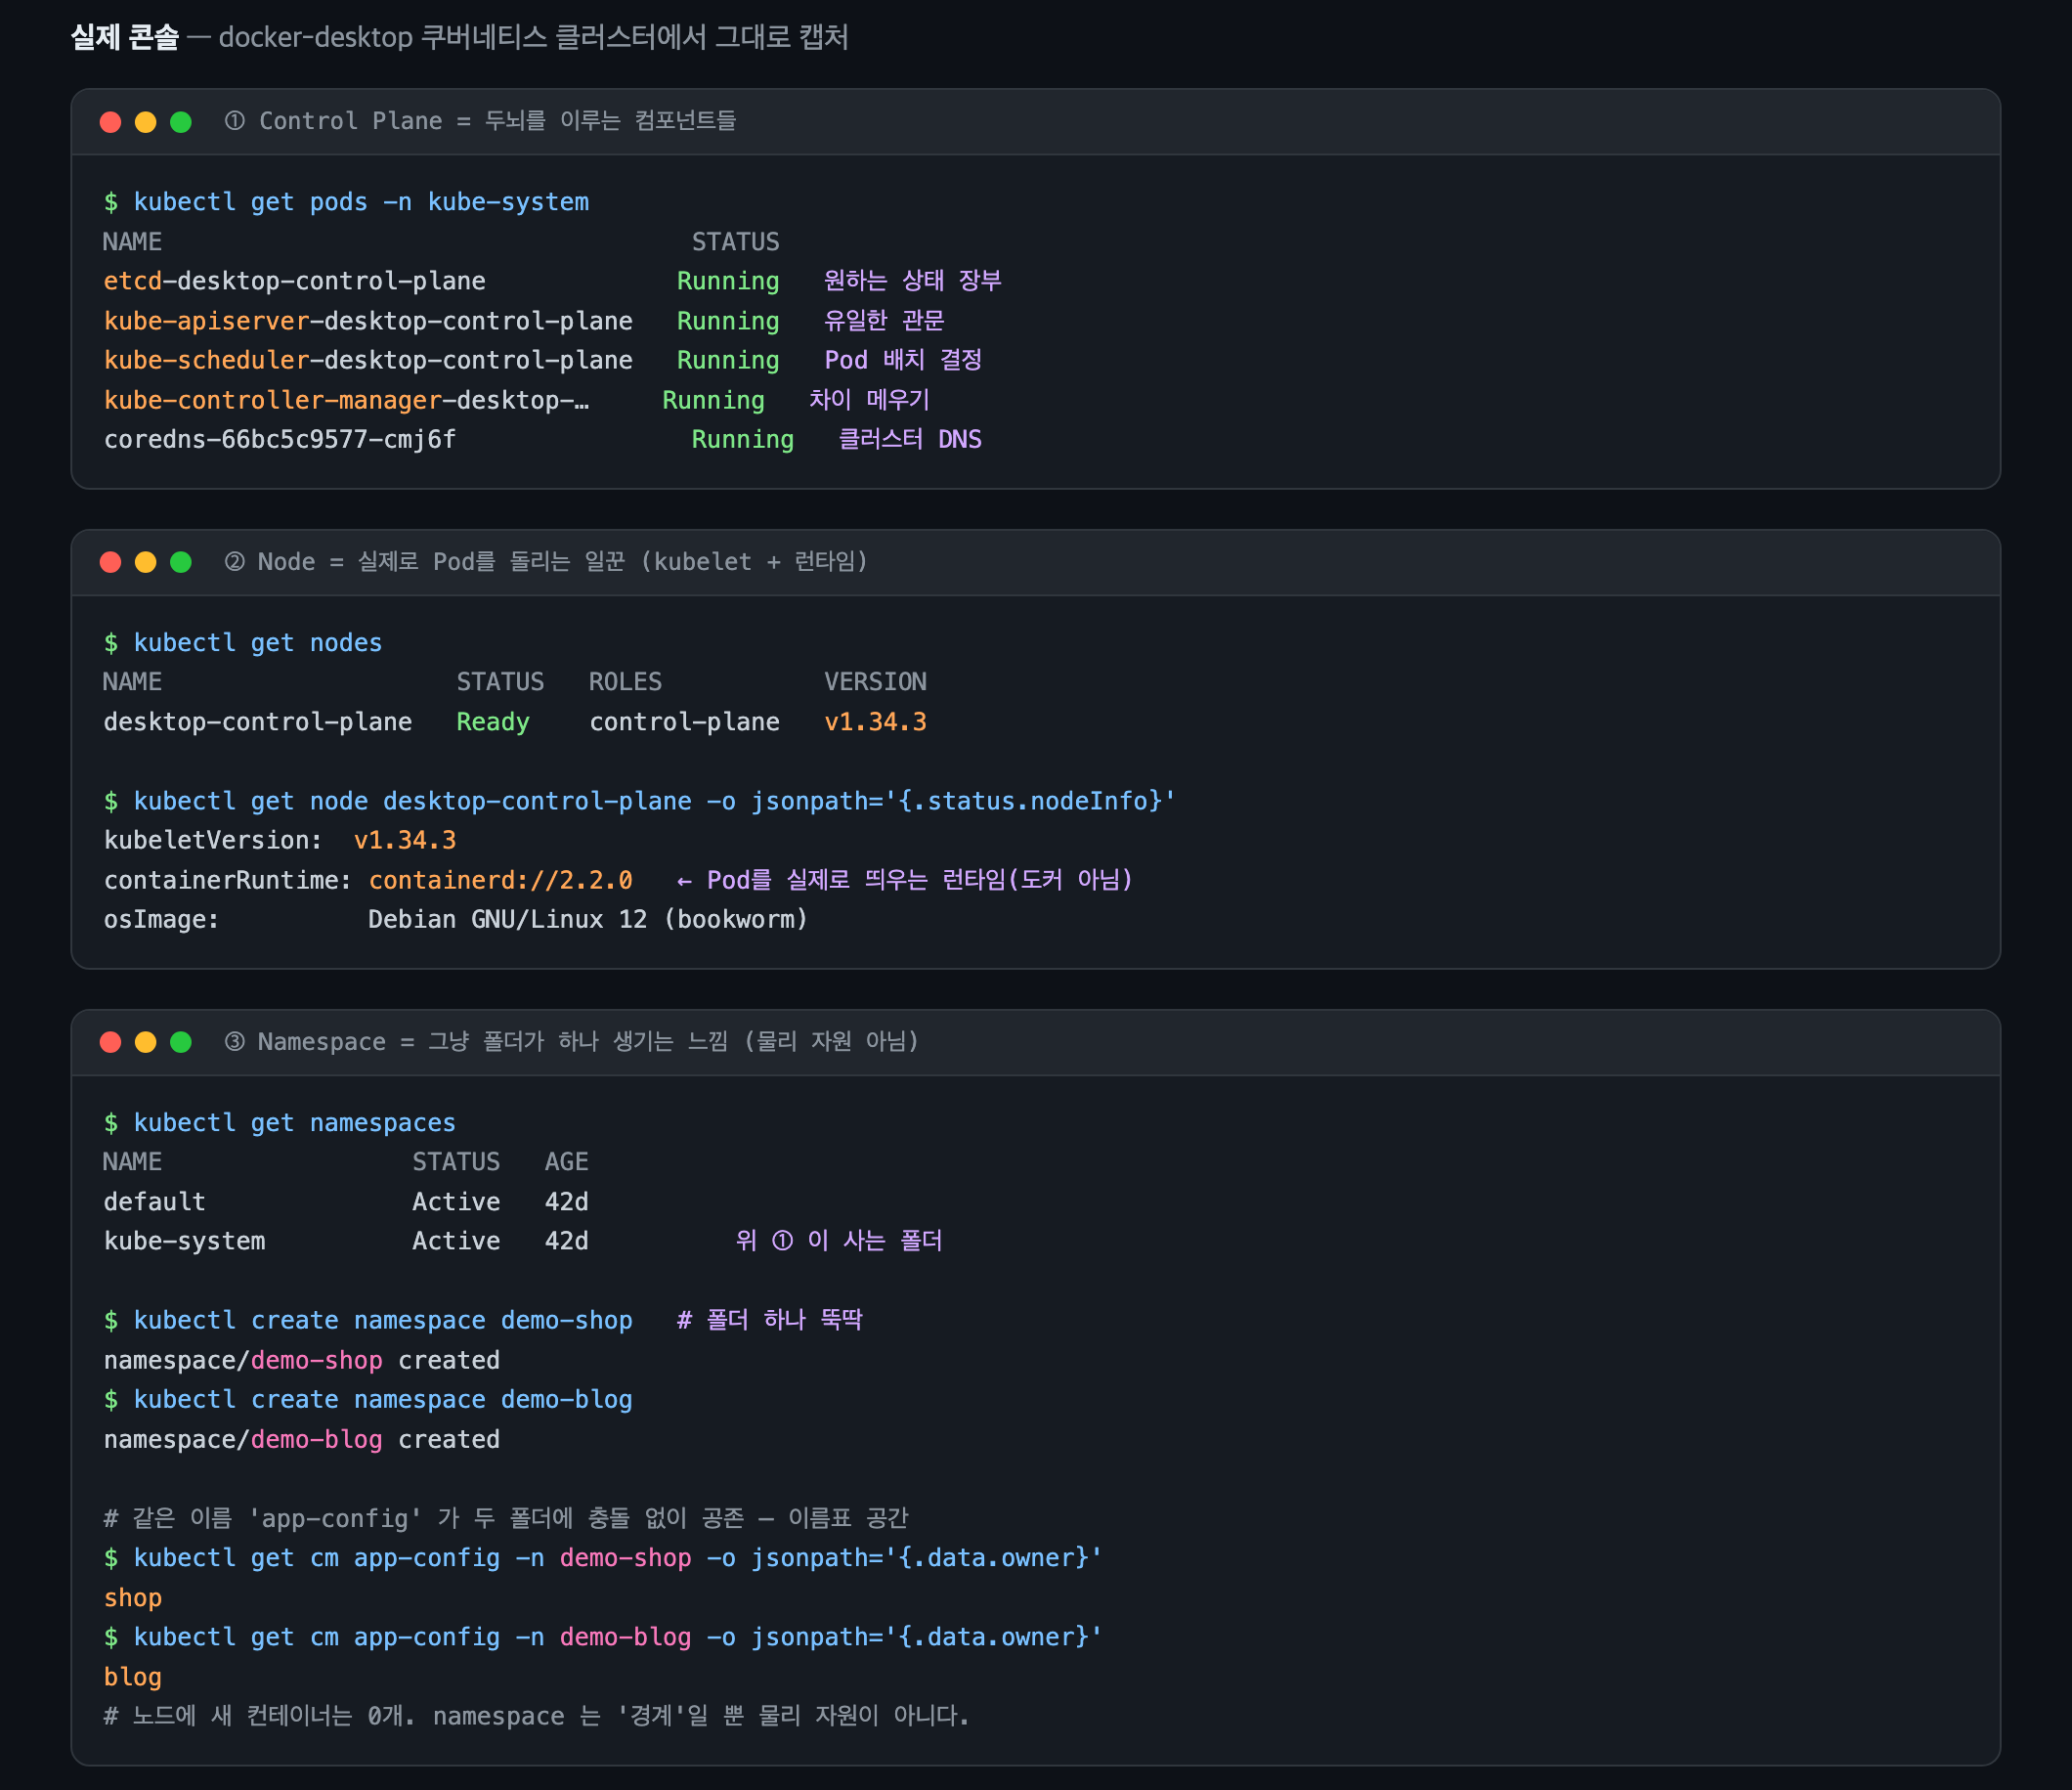
- ① Control Plane —
kube-system폴더 안에 etcd·apiserver·scheduler·
controller-manager가 전부Running. 위에서 설명한 두뇌가 실제로 이렇게 산다. - ② Node —
desktop-control-plane이Ready, kubeletv1.34.3,
런타임은containerd://2.2.0. 도커가 아니라 containerd가 Pod를 띄운다. - ③ Namespace — 내가 처음 네임스페이스를 만들었을 때의 관측이 딱
"그냥 폴더가 하나 생겼다" 였다.kubectl create namespace demo-shop
한 줄이면 폴더가 뚝딱 생기지만, 노드에는 컨테이너가 0개 늘어난다.
게다가app-config라는 같은 이름이 demo-shop·demo-blog 두 폴더에 충돌 없이
공존한다(각각 owner=shop / owner=blog). 물리 자원이 아니라 이름표
공간(경계) 이라는 증거다.
주의 — 같은 단어, 다른 뜻: 여기서의 쿠버네티스 Namespace(논리 폴더)는
A1에서 다룬
리눅스 namespace(컨테이너를 격리하는 커널 기능)와 이름만 같고 완전히 다른
것이다. 전자는 "자원을 어느 그룹에 넣나(조직도)", 후자는 "프로세스가 뭘
볼 수 있나(격리)".
정리
- Control Plane = 두뇌: apiserver(관문)·etcd(장부)·scheduler(배치)·
controller(차이 메우기) - Node = 일꾼: kubelet + containerd 가 실제로 Pod를 띄움
- Pod = 최소 배포 단위: 떼어놓을 수 없는 컨테이너들의 한 묶음
- 선언형 조정 루프 = 원하는 상태만 맡기면 실제를 스스로 맞춘다 → 자기치유
- Namespace(k8s) = 논리 폴더: 물리 자원 없이 이름표 공간만 (리눅스 namespace와 다름)
Control Plane이 "3개 유지"를 어떻게 실제로 보장하는지 — 그 "몇 개를, 어떻게
굴릴까"를 맡는 것이 컨트롤러들이다. 다음 편(A3)에서 ReplicaSet·Deployment·
DaemonSet·StatefulSet·Job/CronJob과 Canary 배포를 같은 방식으로 한 줄씩
정리한다.
참고
- Kubernetes Docs — Cluster Architecture, Pods, Namespaces
- 콘솔 캡처:
docker-desktop로컬 클러스터(Kubernetes v1.34.3, containerd 2.2.0)
이어서 읽기
클러스터의 구성 요소를 한 번 훑었으면, 그 안에서 실제로 트래픽과 자원이 어떻게 갈리는지가 남는다. 규모가 커질 때 iptables 가 무너지는 지점과, 컨테이너 격리의 안쪽을 직접 재 본 글을 아래에 둔다.
답글 남기기