
부제: namespace가 "각자의 세상"을 만들고, cgroup이 "자원 몫"을 정한다
시리즈 B의 마지막 편이자, 시리즈 전체를 처음과 잇는 편이다.
A1에서 컨테이너의
정체를 "커널이 namespace로 격리하고 cgroup으로 제한한 그냥 프로세스" 라고
했다. B1·B2에서 네트워킹(iptables·IPVS)을 팠으니, 이제 한 걸음 더 안쪽 —
namespace와 cgroup 그 자체 — 로 들어간다. 그리고 이것들이 쿠버네티스의
requests/limits·QoS 등급과 어떻게 이어지는지 실측으로 닫는다.
한 줄 정의부터
| 개념 | 한 줄 정의 |
|---|---|
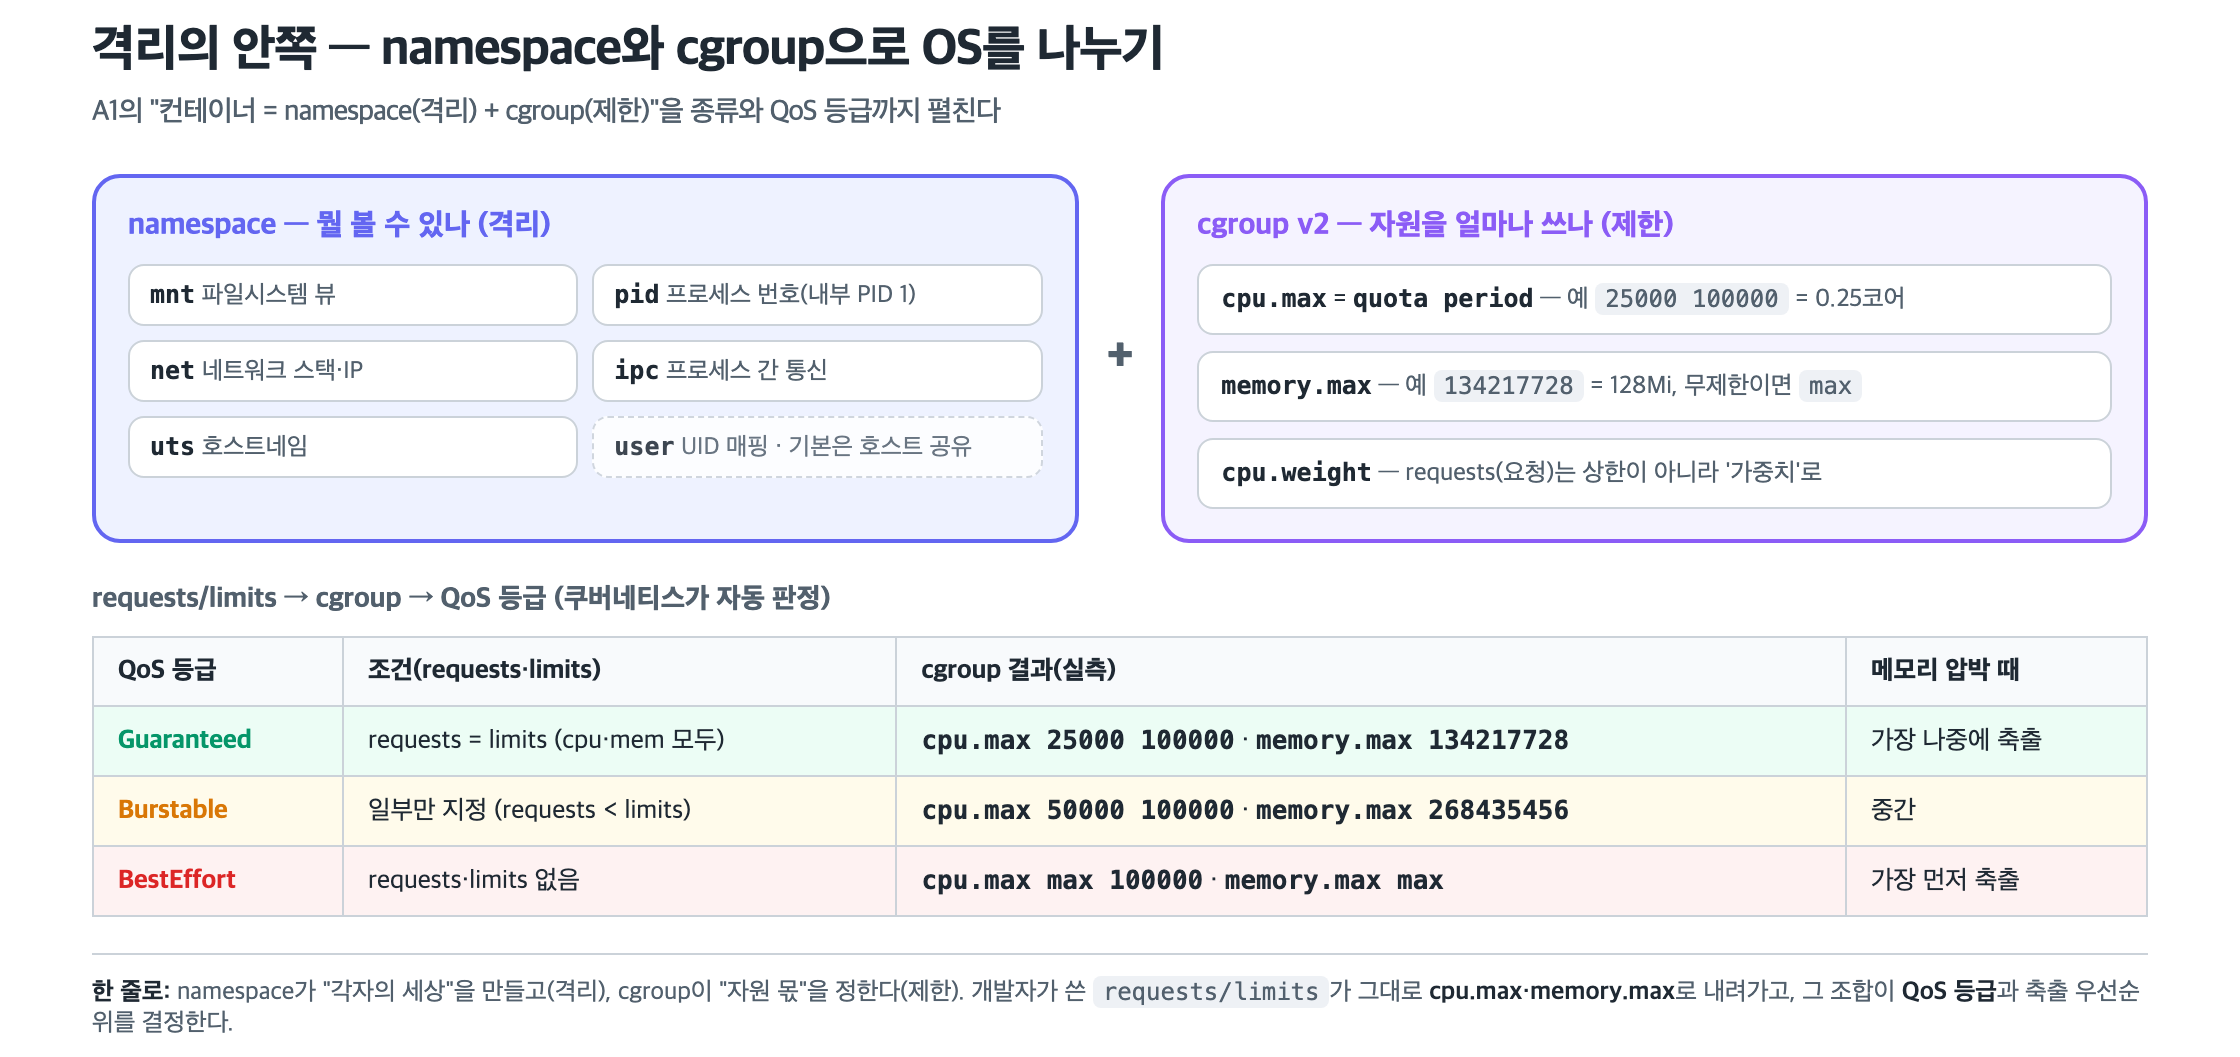
| namespace | 프로세스가 뭘 볼 수 있나를 격리(mnt·pid·net·ipc·uts·user) |
| cgroup v2 | 프로세스가 자원을 얼마나 쓰나를 제한·회계(cpu.max·memory.max) |
| requests/limits | 개발자가 쓴 자원 요청·상한 → 실제 cgroup 값으로 내려감 |
| QoS 등급 | 그 조합으로 정해지는 Guaranteed/Burstable/BestEffort(축출 우선순위) |
namespace — "각자의 세상", 단 완전하지는 않다
namespace는 종류별로 하나의 관점만 격리한다. mnt는 파일시스템 뷰, pid는
프로세스 번호, net은 네트워크 스택, ipc는 프로세스 간 통신, uts는 호스트네임.
이 여러 개가 겹쳐져 "독립된 세상"이라는 착각을 만든다.
그런데 흔히 놓치는 사실이 있다. user namespace는 기본적으로 호스트와
공유된다. 즉 컨테이너 안의 root가 (userns를 켜지 않으면) 호스트의 root와
같은 UID다. "컨테이너는 완전히 격리된 상자"라는 인상과 달리, 격리는
선택적이고 부분적이다. 이게 컨테이너 보안에서 user namespace·rootless가
중요한 이유다.
cgroup — requests/limits가 내려가는 곳
cgroup v2에서 CPU 상한은 cpu.max(= quota period), 메모리 상한은
memory.max로 표현된다. 쿠버네티스에 쓴 limits가 바로 이 값이 된다.
(requests는 상한이 아니라 cpu.weight 같은 가중치로 내려간다 — 경합할
때의 몫이지 한계가 아니다.)
실측 — QoS 3등급을 만들어 cgroup까지 따라가기
requests와 limits를 어떻게 주느냐에 따라 쿠버네티스는 Pod에 QoS 등급을
자동으로 매긴다. 세 가지를 각각 만들어 실제 값을 떠 봤다.
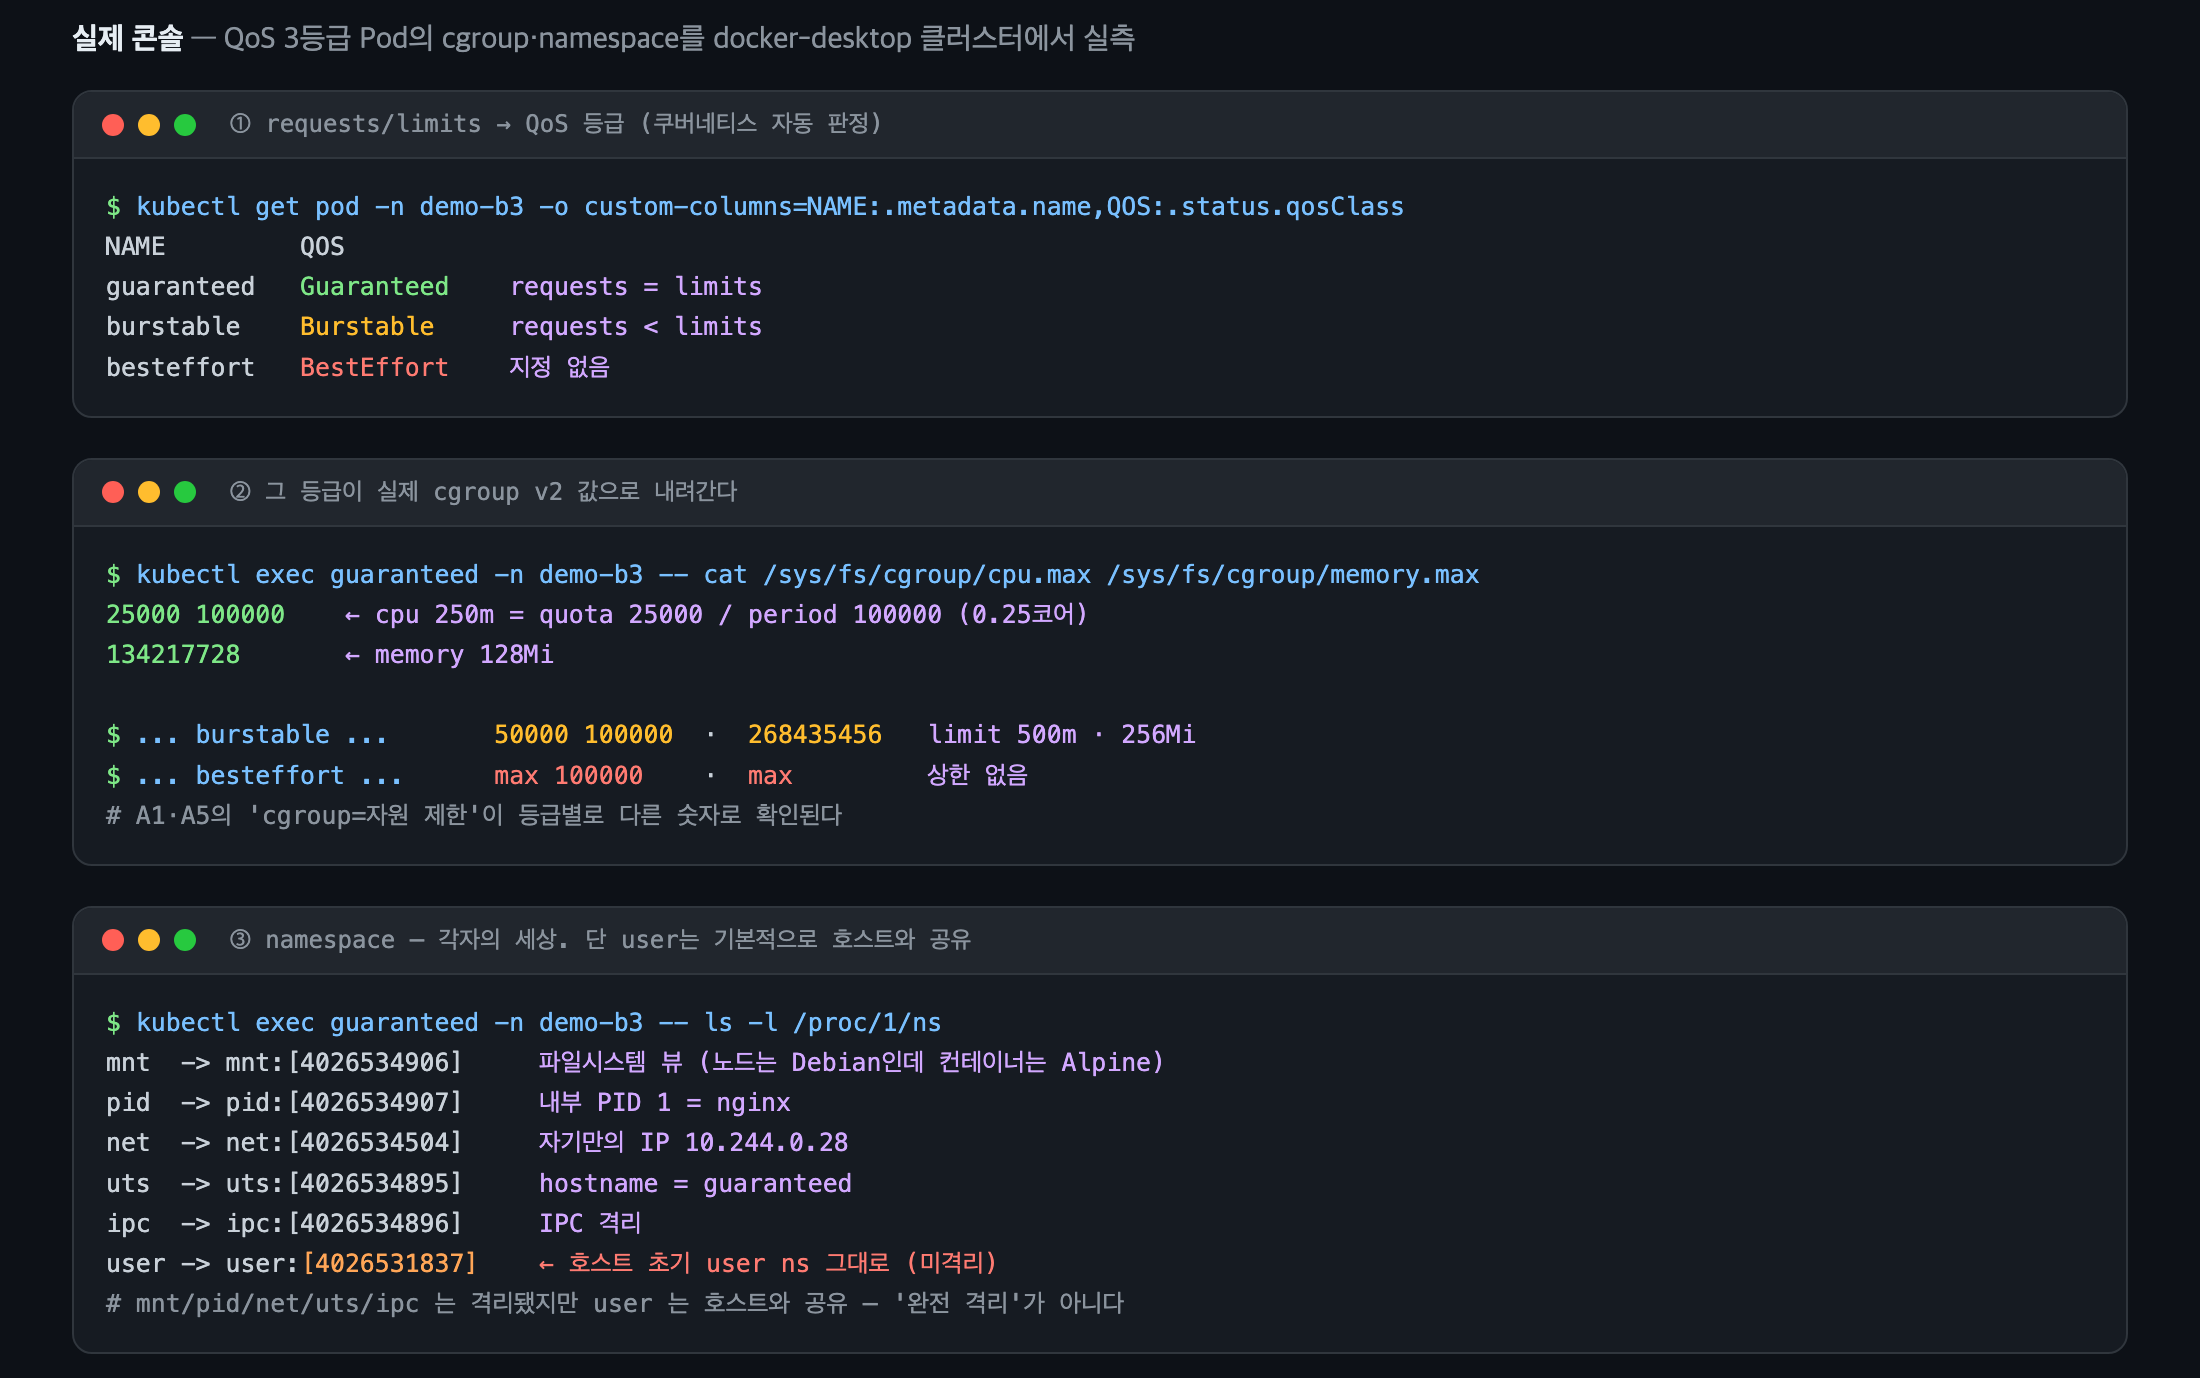
- ① QoS 자동 판정 —
requests = limits(cpu·mem 모두)면 Guaranteed,
일부만/requests < limits면 Burstable, 아무것도 없으면 BestEffort. - ② 등급이 cgroup 값으로 — Guaranteed Pod 안에서
cpu.max는
25000 100000(= 250m = 0.25코어),memory.max는134217728(= 128Mi).
Burstable은 limit 기준50000 100000·268435456(500m·256Mi), BestEffort는
max 100000·max(상한 없음). A1·A5에서
말한 "cgroup=자원 제한"이 등급별로 다른 숫자로 확인된다. - ③ namespace 격리 — 같은 Pod의
/proc/1/ns를 보면 mnt·pid·net·uts·ipc가
전부 호스트와 다른 inode(격리)다. 노드는 Debian인데 컨테이너 안은 Alpine,
내부 PID 1은 nginx, IP는 자기만의10.244.0.28. 하지만 user는
4026531837— 호스트의 초기 user namespace 그대로다(미격리). 위에서 말한
"완전 격리가 아니다"의 증거다.
QoS 등급은 메모리가 부족할 때 누구를 먼저 죽일지(축출) 도 정한다.
BestEffort가 가장 먼저, Guaranteed가 가장 나중. 그래서 중요한 워크로드일수록
requests = limits로 Guaranteed를 노린다.
정리 — 그리고 시리즈 B를 닫으며
- namespace = 격리(각자의 세상), cgroup = 제한(자원 몫). 컨테이너는 이
둘의 조합이다(A1의 확장). - 격리는 부분적이다 — user namespace는 기본 미격리(호스트 공유).
requests/limits가 실제cpu.max·memory.max로 내려가고, 그 조합이
QoS 등급과 축출 우선순위를 정한다(실측으로 확인).
이렇게 시리즈 B(네트워킹과 격리의 안쪽) 를 마친다. B1(iptables)·B2(IPVS·
eBPF)로 "Service가 실제로 어떻게 트래픽을 꽂는가"를, B3로 "컨테이너가 실제로
어떻게 격리·제한되는가"를 실측으로 열었다. 시리즈 A가 "무엇을"이었다면 B는
"어떻게"였다.
다음 갈래는 관측(C) — 코드를 고치지 않고 서비스를 추적하는
auto-instrumentation이, B2에서 만난 그 eBPF와 어떻게 같은 뿌리에서 나오는지,
그리고 그것이 보안 업계의 후킹 기법(Detours·ETW·EDR)과 어떻게 이어지는지를 판다.
참고
- Linux man-pages —
namespaces(7),user_namespaces(7),cgroups(7) - Kubernetes Docs — Pod Quality of Service Classes, Resource Management for Pods
- 실측:
docker-desktop클러스터에서 QoS 3등급 Pod의/sys/fs/cgroup/*·/proc/1/ns덤프
답글 남기기