
한 줄 요약: eBPF 는 커널을 재컴파일하거나 재부팅하지 않고 커널 안에서 내 코드를 돌리는 장치입니다. 이 글은 그 구조(검증기 · JIT · 맵 · 훅)를 먼저 정리하고, 그 위에서 관측 자동계측과 네트워크 데이터패스가 각각 무엇을 얻고 무엇을 포기하는지를 봅니다. 마지막으로 “eBPF 기반”이 예/아니오 질문이 아니라 범위의 문제라는 점을 다룹니다.
이 글의 위치: 기술 블로그 → 인프라 · 쿠버네티스. 관측 스택을 세운 전체 과정은 홈서버 하나로 관측성부터 GitOps까지에 있고, 이 글은 그중 eBPF 부분만 따로 떼어 개념부터 다시 정리한 것입니다.
eBPF 가 푸는 문제 — 커널을 바꾸고 싶은데, 커널을 건드리기는 위험하다
한 줄로 하면 커널 안에서 돌아가는, 검증된 샌드박스 프로그램을 사용자가 끼워 넣는 장치입니다(ebpf.io 의 정의).
원래 BPF 는 Berkeley Packet Filter 였습니다. tcpdump port 443 같은 필터식을 커널이 이해할 수 있는 작은 프로그램으로 컴파일해서, 관심 없는 패킷을 사용자 공간으로 복사하기 전에 커널이 버리게 하는 물건이었습니다. 여기에 e(extended)가 붙으면서 대상이 패킷에서 커널 전반으로 넓어졌습니다.
해결하려는 문제는 오래된 것입니다.
| 커널 동작을 바꾸는 방법 | 대가 |
|---|---|
| 커널을 패치하고 재컴파일 | 재부팅. 그리고 업스트림에 머지되기까지 오랜 시간 |
| 커널 모듈을 작성 | 재부팅은 없지만 버그 하나가 커널 패닉. 시스템 전체가 죽는다 |
| eBPF | 검증기를 통과한 프로그램만 로드된다. 무한 루프도, 잘못된 메모리 접근도 로드 시점에 거부 |
그래서 eBPF 프로그램은 “커널 안에서 도는데 커널을 죽일 수 없는” 위치에 있습니다. 이걸 보장하는 것이 검증기(verifier)입니다 — 프로그램이 반드시 종료하는지, 접근하는 메모리가 전부 경계 안인지, 그 컨텍스트에서 허용된 헬퍼 함수만 부르는지를 로드하기 전에 정적으로 확인합니다. 통과하면 JIT 로 네이티브 기계어가 되어 인터프리터 없이 돕니다.
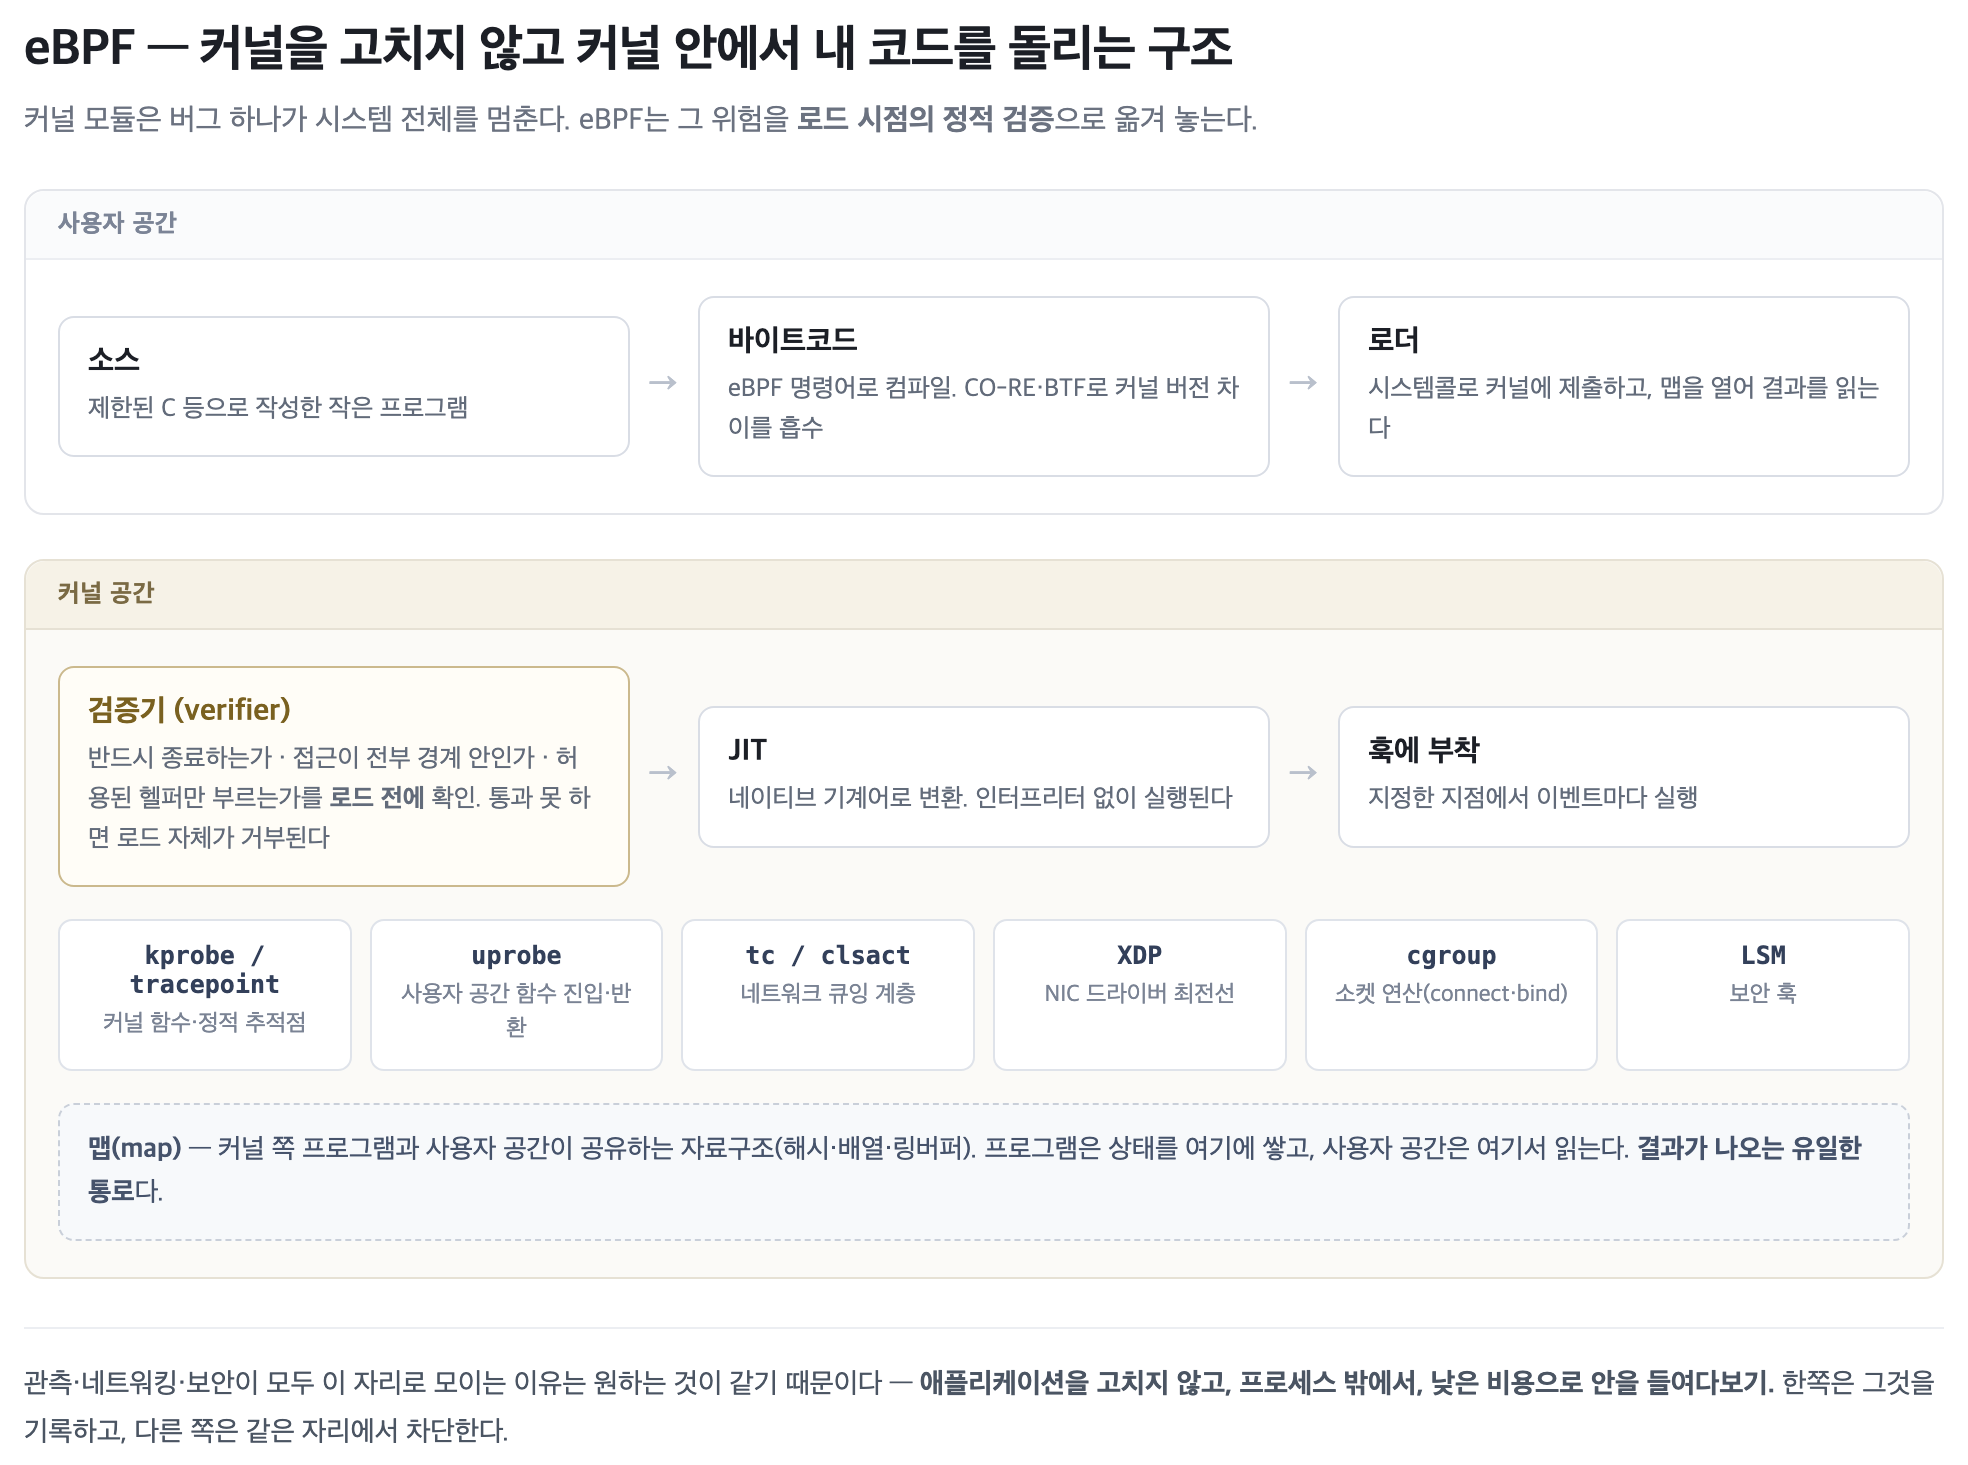
구성 요소는 셋뿐이라 개념이 단순합니다. 프로그램(특정 훅에 붙어 이벤트마다 실행되는 코드), 맵(커널 쪽 프로그램과 사용자 공간이 공유하는 자료구조 — 결과가 나오는 유일한 통로), 훅(프로그램을 어디에 붙일 것인가). 이 기술의 실제 파괴력은 세 번째, 붙일 수 있는 자리가 많다는 데 있습니다.
| 훅 | 붙는 지점 | 쓰임 |
|---|---|---|
kprobe / tracepoint |
커널 함수 · 정적 추적점 | 시스템콜 관측 |
uprobe |
사용자 공간 프로그램의 함수 | 앱 코드 수정 없이 함수 진입/반환 관측 |
tc / clsact |
네트워크 큐잉 계층 | 패킷 필터 · 리디렉션 · 로드밸런싱 |
XDP |
NIC 드라이버 최전선 | 커널 스택에 올리기 전에 처리 (DDoS 차단 등) |
cgroup |
소켓 연산(connect/bind) | 소켓 레벨 로드밸런싱 |
LSM |
보안 훅 | 정책 강제 |
여기에 CO-RE(Compile Once, Run Everywhere) 와 BTF 가 붙습니다. 커널 버전마다 구조체 필드 오프셋이 다른데, BTF 라는 타입 정보를 커널이 들고 있으면 로더가 그 차이를 흡수합니다. 커널마다 다시 컴파일하지 않아도 되는 이유이고, 뒤에 나올 자동계측의 전제 조건이기도 합니다.
왜 관측과 네트워킹과 보안이 전부 여기로 모이나
세 분야가 원하던 것이 같기 때문입니다. 애플리케이션을 고치지 않고, 프로세스 밖에서, 낮은 비용으로 안을 들여다보기.
- 관측: 앱에 SDK 를 심지 않고 HTTP 요청을 세고 싶다 →
uprobe로 함수 진입/반환을 잡는다 - 네트워킹: 서비스 IP 를 파드 IP 로 바꾸는 일을 규칙 수천 개 대신 하고 싶다 →
tc/cgroup에서 해시 조회 한 번으로 끝낸다 - 보안: 어떤 프로세스가 어떤 파일을 여는지 감시하고 싶다 → 같은 자리에 다른 프로그램을 붙인다
관측과 보안이 같은 기술을 쓰는 것은 우연이 아닙니다. 둘 다 “남의 코드가 하는 일을 그 코드를 고치지 않고 알아내기”이고, 방향만 다릅니다. 한쪽은 기록하고 한쪽은 차단합니다.
자동계측 — “코드 수정 없음”은 “조건 없음”이 아니다
eBPF 자동계측 도구(Grafana Beyla 등)는 노드에 떠서 실행 중인 프로세스에 프로브를 붙이고, HTTP/gRPC/SQL 호출을 커널 레벨에서 포착해 스팬과 RED 메트릭(Rate · Errors · Duration)을 만듭니다. 앱 코드 수정도, 재배포도 없습니다. 서비스가 여럿이고 전부 손대야 한다면 계측은 시작조차 못 하므로, 이 성질의 값은 큽니다.
다만 성립 조건이 있습니다. uprobe 는 “이 바이너리의 이 함수 진입 지점에 붙여라”라고 지시하는 방식으로 동작합니다. 그러려면 함수가 바이너리 어디에 있는지 알아야 하고, 그 정보가 심볼 테이블입니다.
여기가 이 절의 핵심입니다. eBPF 자동계측은 앱 소스를 고치지 않는 대신 바이너리가 자기를 설명해 주기를 요구합니다. 심볼이든 BTF 든, 어딘가에는 메타데이터가 있어야 합니다. 크기를 줄이려고 심볼을 떼어낸 stripped 빌드에는 붙을 자리가 없고, 이건 설정으로 고칠 수 있는 문제가 아닙니다 — 빌드를 바꾸거나 도구를 바꿔야 합니다.
실제로 이 조건 때문에 대안으로 돌아간 적이 있습니다. 대안은 사이드카 프록시입니다. 파드마다 프록시를 넣고 모든 트래픽을 그 프록시로 통과시키면, 프록시가 셉니다. 바이너리가 어떻게 빌드됐는지와 무관합니다 — 트래픽만 지나가면 되니까요.
둘의 차이는 취향이 아니라 관측 지점의 위치에서 옵니다.
| 항목 | eBPF 자동계측 (밖에서) | 사이드카 프록시 (경로 안에서) |
|---|---|---|
| 위치 | 노드 단위 에이전트 — 프로세스 밖에서 관측 | 파드 사이드카 — 트래픽 경로 안 |
| 계측 원리 | 프로세스에 프로브 attach | 프록시가 요청을 대신 통과시킨다 |
| stripped 바이너리 | ❌ 심볼이 없어 못 붙는다 | ✅ 무관하다 |
| mTLS · 트래픽 정책 | 없음 (관측만) | ✅ 같이 딸려온다 |
| 비용 | 노드당 1개 · eBPF 맵 메모리 | 파드마다 프록시 하나 |
| 도입 순단 | 없음 | 주입 시 파드 재시작 |
사이드카는 확실하지만 공짜가 아닙니다. 프록시가 파드 수만큼 늘어나고, 코어와 메모리가 넉넉하지 않은 환경에서는 관측 하나를 위해 지불하는 비용이 됩니다. 그리고 그 비용이 다음 선택을 부릅니다.
데이터패스를 eBPF 로 바꾼다는 것 — 기능이 아니라 자료구조의 교체
사이드카를 걷어내는 방향은 CNI 자체를 eBPF 기반으로 바꾸는 것입니다. 노드 하나에 있는 프록시가 L7 을 처리하므로 파드마다 프록시를 두지 않고 비슷한 것을 노립니다. 그런데 이 전환에서 개념적으로 가장 볼 만한 부분은 서비스 로드밸런싱입니다.
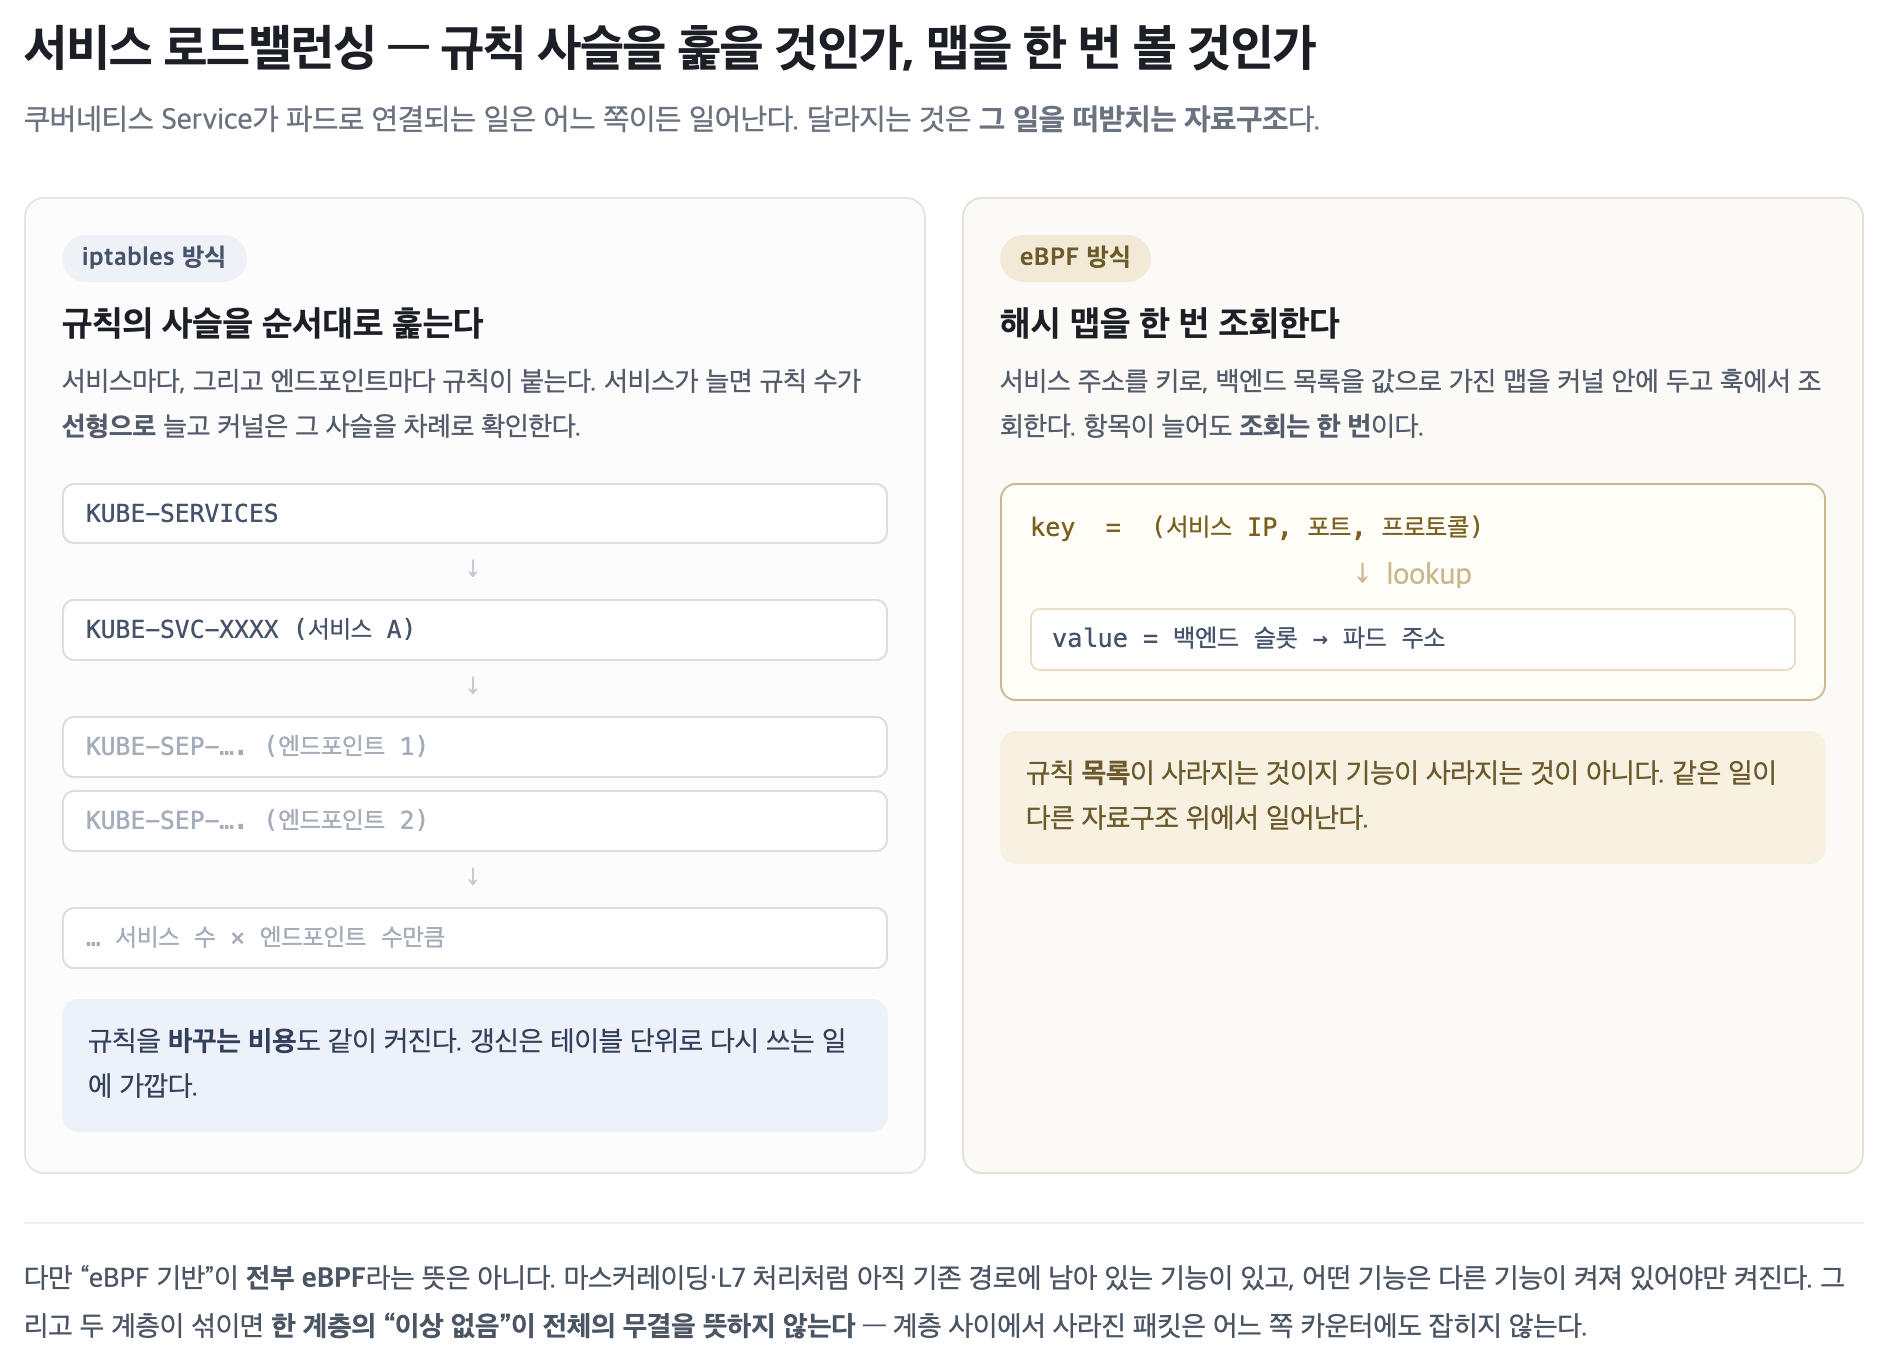
원래 쿠버네티스 Service 는 iptables 규칙의 사슬로 구현됩니다. 서비스가 늘면 규칙이 선형으로 늘고, 커널은 그 사슬을 순서대로 훑습니다. eBPF 는 그것을 맵 조회 한 번으로 바꿉니다(Cilium — kube-proxy replacement).
| 항목 | 전환 결과 |
|---|---|
| 사이드카 프록시 제거 | 8 파드 / 약 603 Mi 회수 |
| kube-proxy 제거 | KUBE- iptables 규칙 490 → 0 |
| 서비스 로드밸런싱 | eBPF 맵 245 엔트리 가 대신한다 |
여기서 읽어야 할 것은 “490 이 0 이 됐다”가 아니라 490 개의 규칙이 245 개의 맵 엔트리로 형태를 바꿨다는 사실입니다. 기능이 빠진 것이 아니라 같은 일이 다른 자료구조 위에서 일어나고, 그래서 조회 비용이 항목 수에 비례하지 않게 됩니다. 규칙을 갱신하는 비용도 함께 달라집니다.
“eBPF 기반”은 예/아니오 질문이 아니다
eBPF CNI 를 쓴다는 말은 모든 경로가 eBPF 라는 뜻이 아닙니다. 실제로 갈리는 것은 어디까지 eBPF 이고 어디서 기존 경로로 떨어지는가이고, 이건 문서가 아니라 재봐야 알 수 있습니다. 이 노드의 전수 측정 결과를 예로 놓습니다.
[ eBPF 로 도는 부분 ]
CNI            05-cilium.conflist 하나 (Cilium 1.20.0)
BPF 프로그램    768개 · 맵 132개
clsact attach   enp3s0 · tailscale0 · cilium_host/net/vxlan · 모든 lxc*
kube-proxy      완전 대체 (파드 0, KUBE-SERVICES 규칙 0)
서비스 LB       245 엔트리

[ 여전히 legacy iptables 인 부분 ]
Routing:      Host: Legacy          ← BPF host routing 이 아니다
Masquerading: IPTables
bpf-lb-sock:  false                 ← 소켓 LB 꺼짐, cgroup 프로그램 0개
iptables 규칙  filter 155 / nat 23 / mangle 14
이렇게 갈리는 이유는 대개 기능 사이의 의존 관계입니다. 에이전트 로그에 그대로 남아 있었습니다.
BPF host routing requires enable-bpf-masquerade. Falling back to legacy host routingmasquerade 가 iptables 라서 host routing 까지 끌려 내려간 것입니다(Cilium — Masquerading). bpf.masquerade 를 켜면 둘 다 올라가지만, 별건의 장애를 조사하는 중이라면 지금 켜는 순간 변수가 셋이 동시에 바뀝니다. 성능을 위해 켜는 것보다 원인 규명을 위해 꺼두는 판단이 우선할 수 있고, 그렇게 정했다면 그 이유를 설정 파일에 주석으로 남겨 두는 편이 낫습니다. 안 그러면 다음에 보는 사람이 “왜 꺼져 있지”부터 다시 조사합니다.
측정 함정 — 낡은 도구는 “없다”고 대답한다
이건 따로 적어 둘 값이 있습니다. eBPF 프로그램이 붙었는지 보려고 흔히 이렇게 합니다.
tc filter show dev enp3s0 ingress # → 아무것도 안 나온다전부 0 을 반환합니다. 그대로 읽으면 “이 노드는 eBPF 를 안 쓴다”는 정확히 반대되는 결론에 도달합니다. 이유는 최근 버전이 tcx(신형 BPF link 방식)로 붙기 때문이고, 예전 tc filter 는 그걸 표시하지 못합니다. 올바른 도구는 이쪽입니다.
bpftool net show # 768개 프로그램이 여기서 보인다도구가 낡으면 “없다”고 대답하고, 그 대답은 진짜 없는 것과 구분되지 않습니다. 앞선 Geomap 편에서 다룬 빈 패널 문제와 정확히 같은 형태입니다 — 조용한 0 은 사실이 아니라 관측의 한계일 수 있습니다.
eBPF 가 못 하거나 안 하는 것
유행하는 기술일수록 한계를 같이 적어 두는 편이 낫습니다. 아래는 전부 구조에서 나오는 한계라 설정으로 없앨 수 없는 것들입니다.
① L7 은 eBPF 가 직접 하지 않습니다. HTTP 헤더를 보고 판단하는 일은 커널 훅에서 하기엔 무거워서, eBPF CNI 도 L7 은 프록시로 리다이렉트해서 처리합니다. 그리고 그 리다이렉트는 TPROXY, 즉 iptables 경로를 탑니다. “eBPF 로 L7 정책을 건다”는 실제로는 “eBPF 가 패킷을 프록시로 보낸다”에 가깝습니다.
② drop 카운터는 자기 계층에서 버린 것만 셉니다. 패킷이 분명히 사라지는데 eBPF drop 이 0건인 상황이 있습니다. 이걸 “네트워크 문제 아님”의 증거로 읽으면 틀립니다. eBPF 계층과 iptables 계층 사이에서 없어진 패킷은 어느 쪽 카운터에도 안 잡힙니다. 계층이 섞인 환경에서는 한 계층의 “이상 없음”이 전체의 무결을 뜻하지 않습니다.
③ 해상도에는 바닥이 있습니다. 사이드카를 걷어내고 커널 관측 계층으로 지연을 보면 히스토그램 최저 버킷이 5 ms 인 경우가 있습니다. 그보다 빠른 요청은 전부 한 칸에 뭉칩니다. 내부 호출 대부분이 5 ms 미만인 환경에서는 지연 분포를 사실상 못 봅니다. 사이드카 대비 명확한 후퇴이고, 이걸 모르면 “이관 후 성능이 나빠졌다”로 오독하기 쉽습니다.
④ 커널과 버전이 곧 제약입니다. eBPF 계열 도구는 커널 기능에 밀착해 있어서 위쪽(쿠버네티스)과 아래쪽(커널) 양쪽에 버전이 묶입니다. 최신 쿠버네티스를 지원하는 CNI 버전이 하나뿐이라 선택지가 없는 상황도 생깁니다.
정리 — 언제 eBPF 이고 언제 아닌가
참고 문서
- ebpf.io — What is eBPF?
- Linux Kernel Docs — eBPF verifier · BTF
- man 8 tc-bpf — tc/clsact 계층 부착
- Cilium — kube-proxy replacement · Masquerading
- Grafana Beyla 문서
| 상황 | 선택 |
|---|---|
| 앱 계측을 코드 수정 없이, 대상이 심볼이 남은 빌드거나 스크립트 언어 | eBPF 자동계측. 가볍고 사이드카가 없다 |
| stripped 바이너리거나, RED 에 더해 mTLS · 트래픽 정책까지 필요 | 사이드카 메시. 확실하지만 파드마다 비용을 낸다 |
| 서비스 수가 많아 규칙 사슬 자체가 부담 | eBPF CNI 로 데이터패스 교체 |
| 원인 규명 중 | 아무것도 켜지 않는다. 변수를 하나씩 바꾼다 |
그리고 이 글에서 제일 오래 남는 문장 하나. “eBPF 기반이냐”보다 “어디까지 eBPF 이냐”가 답해야 할 질문입니다. 그리고 그 답은 문서에 없습니다 — 프로그램이 실제로 어디에 붙어 있는지, 어떤 기능이 어떤 기능에 끌려 내려갔는지는 맞는 도구로 재봐야 나옵니다.
남겨둔 것
bpf.masquerade는 꺼진 상태입니다. 진행 중인 조사가 끝나야 켭니다. 켜면 host routing 도 같이 BPF 로 올라갑니다.bpf-lb-sock(소켓 LB)도 꺼져 있습니다. cgroup 훅 프로그램이 0개입니다.- eBPF 자동계측은 opt-in 설정으로 보존만 해뒀습니다. 심볼이 남은 빌드가 생기면 재시도할 값이 있어서, 설정과 실패 사유를 주석으로 함께 남겼습니다.
- L7 리다이렉트 실패는 미해결입니다. 별도 조사 기록으로 남기고 업스트림에 이슈를 냈습니다.
답글 남기기